VITS端到端文本转语音模型
分类:工具实测 浏览量:5
摘要:
VITS是一个端到端的文本转语音开源项目,它直接将文本转换成自然语音,跳过了传统TTS系统的中间步骤。对于电商从业者,它能解决文字内容转语音的需求,例如生成有声内容或语音提示,并支持通过训练实现多说话人语音合成,以制作不同音色的语音。该工具主要适合有编程基础的开发者、对语音合成感兴趣的技术爱好者,以及希望研究或复现模型的研究者或学生。
VITS端到端文本转语音模型:从文字到语音的开源方案
VITS是一个端到端的文本转语音开源项目,由Jaehyeon Kim等人开发,在GitHub上有7904个star。它直接把文本转成自然语音,跳过了中间步骤,适合开发者研究。
适合谁
这几类人可能会用到它:
- 有编程基础的开发者:需要Python 3.6以上环境,能操作命令行,想在应用里加入语音合成功能。
- 技术爱好者:对生成式模型、语音合成感兴趣,想试试最新的TTS技术。
- 研究者或学生:想了解端到端TTS模型的设计,参考或复现论文方法。
能解决什么问题
- 文字内容转语音:输入文本,生成对应的语音文件,用在有声内容、语音提示这些场景。
- 多说话人语音合成:支持用VCTK多说话人数据集训练,生成不同音色的语音。
- 训练自己的语音模型:用自己的数据集,按项目说明做预处理和训练,得到定制化的语音合成效果。
怎么开始用
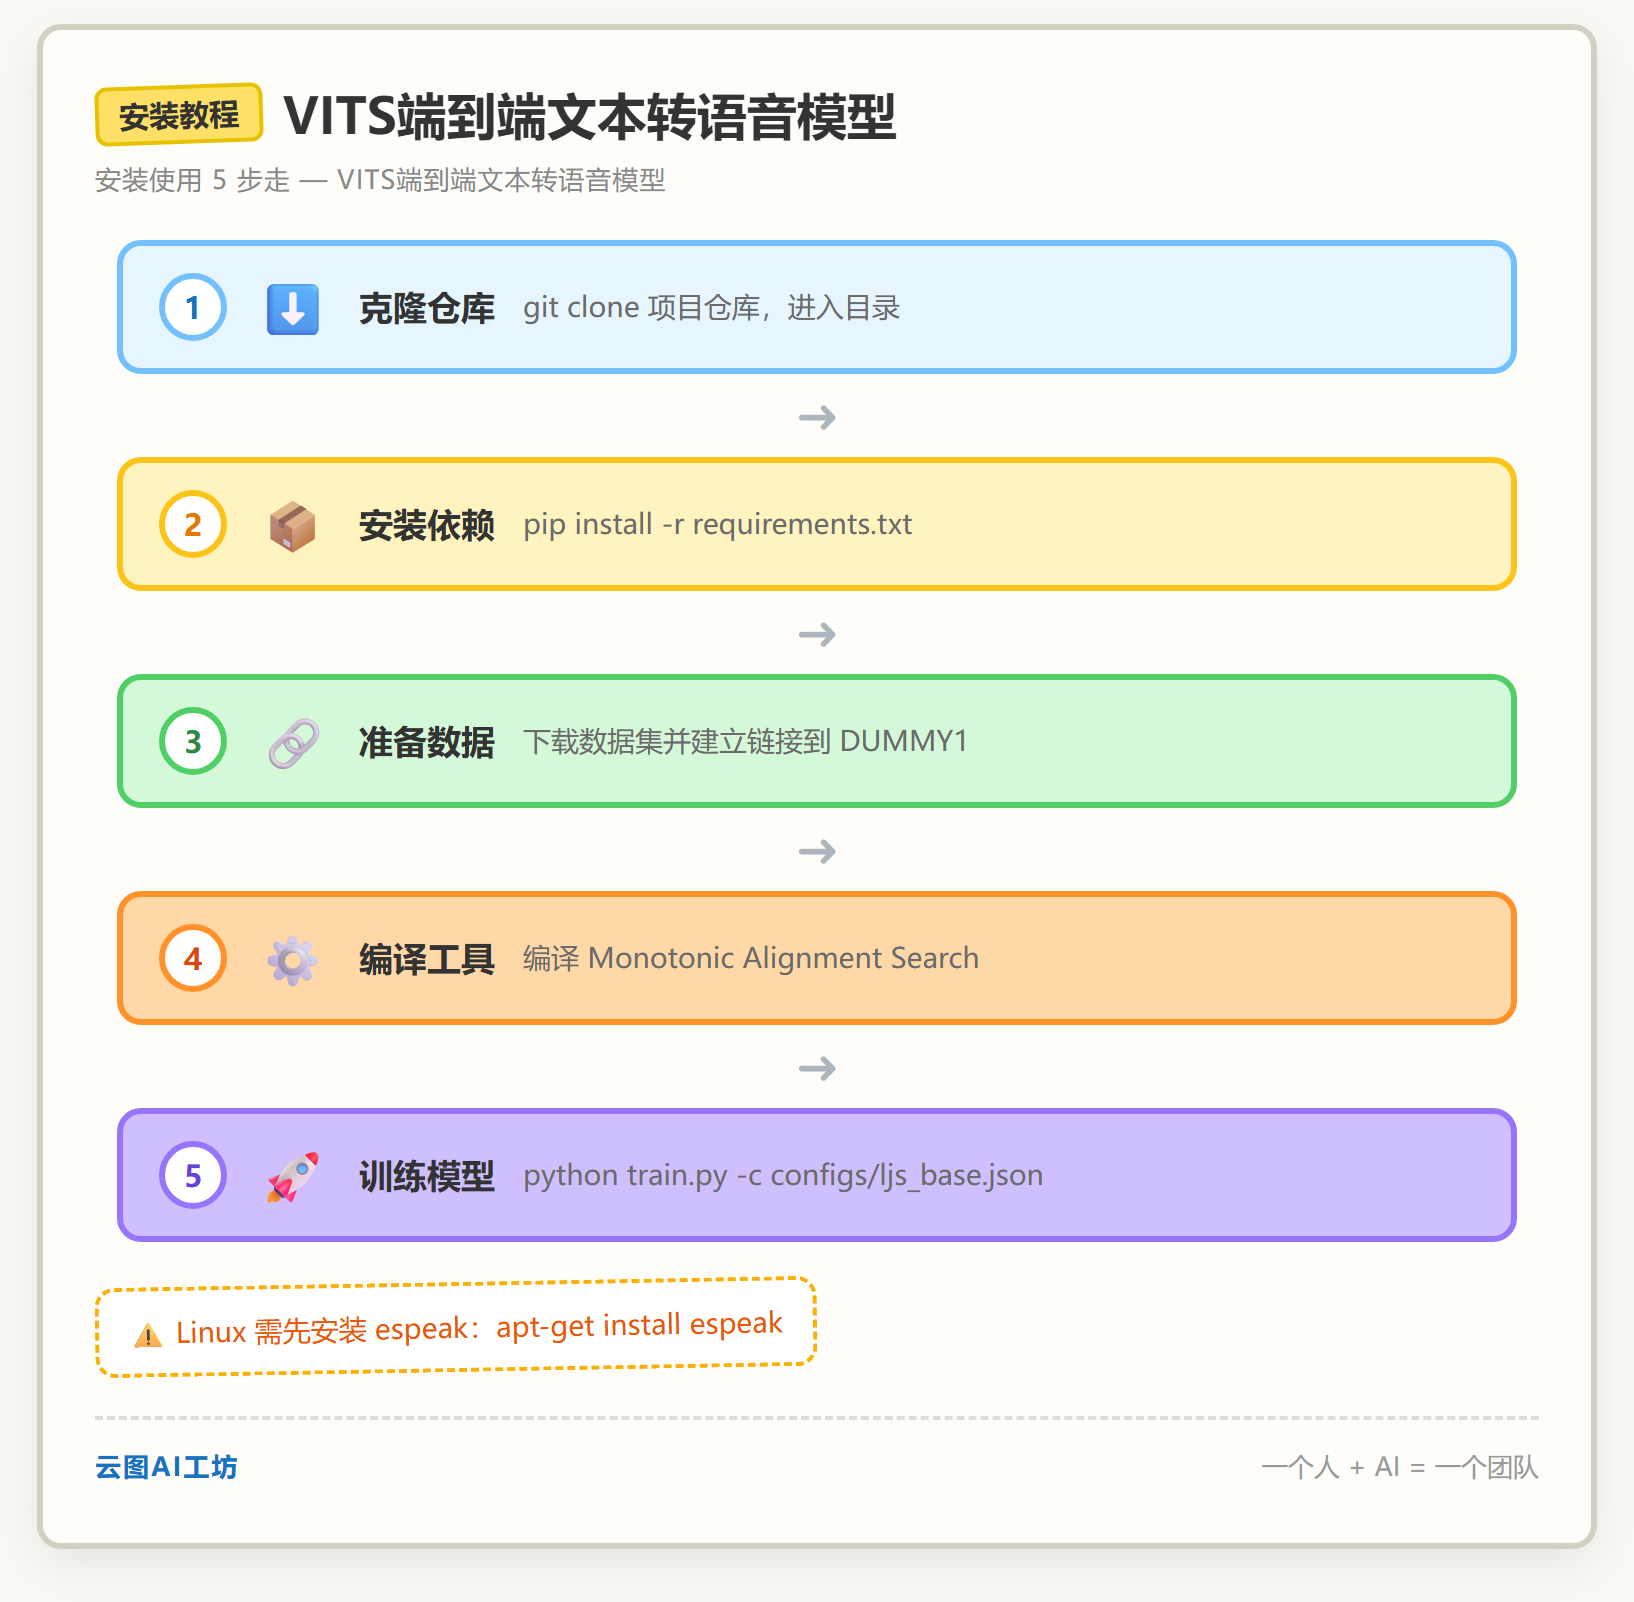
先准备好环境,克隆仓库并安装依赖:
git clone https://github.com/jaywalnut310/vits.git
cd vits
pip install -r requirements.txt
Linux系统可能需要先装espeak:
apt-get install espeak
下载LJ Speech数据集,然后建立链接:
ln -s /path/to/LJSpeech-1.1/wavs DUMMY1
要用多说话人模型,还得下载VCTK数据集并降采样到22050 Hz,然后链接到DUMMY2。
用自己的数据集时,需要先编译Monotonic Alignment Search并做预处理:
cd monotonic_align
python setup.py build_ext --inplace
训练模型:
python train.py -c configs/ljs_base.json -m ljs_base
多说话人训练:
python train_ms.py -c configs/vctk_base.json -m vctk_base
推理示例看项目里的inference.ipynb文件。
优点和坑
优点:
- 端到端设计,训练一步到位,比传统的两阶段TTS系统流程简单。
- 论文里说在LJ Speech数据集上的主观评分接近真实语音,生成质量可以。
- 提供了预训练模型和Colab交互式demo,方便先体验。
坑:
- 部署有难度:得自己处理数据集下载、环境配置、Cython编译这些步骤,新手容易卡住。
- 资源要求不低:训练需要GPU和足够的显存,用普通CPU会非常慢。
- 数据准备繁琐:用自己的数据集得做预处理,项目只预处理好LJ Speech和VCTK的音素。
- 依赖较多:需要装espeak这类系统级依赖,不同平台可能遇到其他问题。
适合你吗
如果你是有经验的开发者,想在本地跑一个高质量的TTS模型,或者对语音合成技术感兴趣,VITS可以试试。它有预训练模型和Colab demo,能先体验再决定要不要深入。
如果你只想找个开箱即用的语音合成工具,不想折腾环境和数据,这个项目可能不合适——部署门槛不低,得花时间解决依赖和编译问题。另外,项目更新停在2026年11月,后续维护情况得自己留意。
注意:本文基于公开资料整理,没做一手实测。具体效果和部署体验以官方文档和实际运行为准。
常见问题
VITS语音合成是什么?
VITS是一个端到端的文本转语音开源项目,由Jaehyeon Kim等人开发。它直接把文本变成自然语音,不用中间步骤,在GitHub上有7904个star。开发者、技术爱好者或研究者可以用它来集成语音合成、研究TTS技术,或者训练自己的语音模型。
VITS模型怎么安装和配置环境?
先克隆GitHub仓库,再安装依赖。命令是:git clone https://github.com/jaywalnut310/vits.git,然后cd vits,执行pip install -r requirements.txt。Linux用户还要装系统依赖:apt-get install espeak。项目需要Python 3.6以上,涉及Cython编译,新手可能觉得有点难。
VITS支持多说话人语音合成吗?
支持。项目可以用VCTK多说话人数据集训练,生成不同音色的语音。训练多说话人模型需要下载VCTK数据集,降采样到22050 Hz,然后运行命令python train_ms.py -c configs/vctk_base.json -m vctk_base。这样就能做出多种语音角色。
VITS是免费的吗?训练需要什么资源?
VITS是开源项目,免费。但训练自己的语音模型对硬件有要求,需要GPU和足够显存,用普通CPU训练会非常慢。用自己的数据集还得做繁琐的预处理,项目只预处理好LJ Speech和VCTK数据集的音素。
VITS和传统的两阶段TTS系统比有什么优点?
VITS是端到端设计,训练一步完成,流程比传统的两阶段系统更简单。论文显示,它在LJ Speech数据集上的主观评分接近真实语音,生成质量不错。项目还提供了预训练模型和Colab交互式demo,方便上手试试。
相关工具推荐
- 了解VoiceCraft零样本语音克隆,获取制作带货口播音频的免费方案
- 使用QuickRecorder这款轻量级macOS录屏工具进行屏幕录制
- 探索Obscura开源无头浏览器,用于AI代理和网页抓取
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。