PaddleSpeech语音工具包
分类:工具实测 浏览量:5
摘要:
PaddleSpeech是百度开源的一个语音工具包,集成了语音识别、语音合成、语音翻译、说话人验证和关键词唤醒等多种语音能力。它能帮助开发者快速搭建语音功能原型,解决如为应用添加语音转写、文字转语音、音频翻译或本地离线部署语音服务等需求。该工具尤其适合想给应用加语音能力的开发者、做语音方向研究的技术爱好者,以及需要离线或本地部署语音服务的团队。
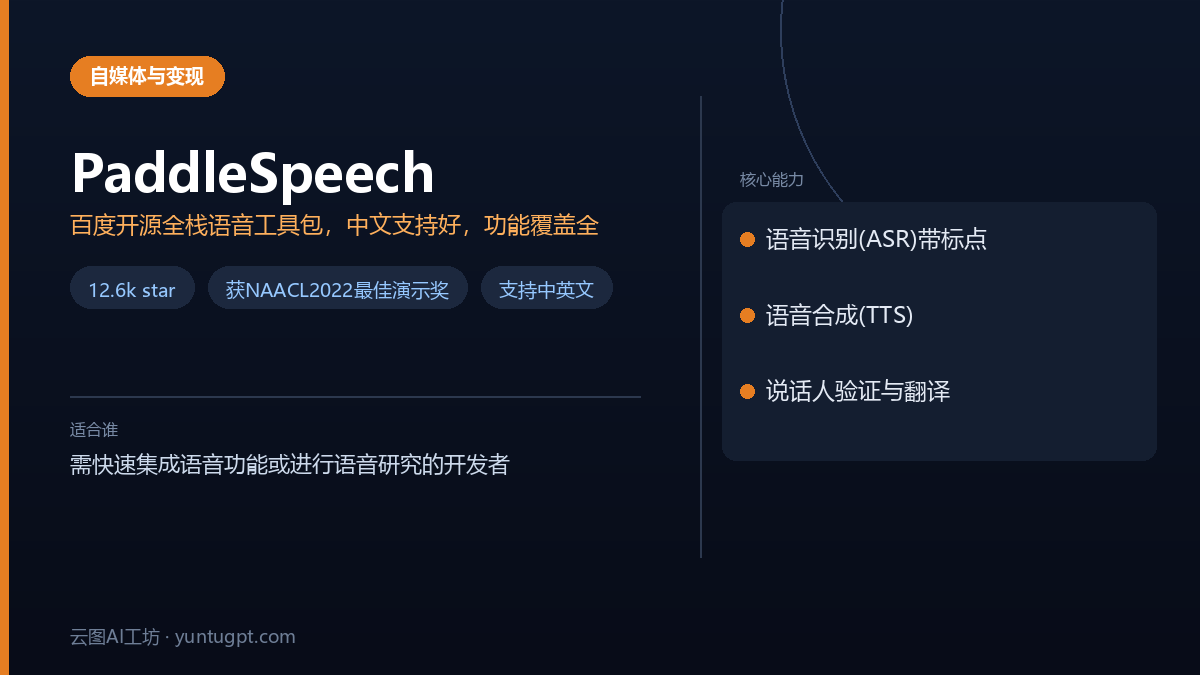
PaddleSpeech 是百度开源的一个语音工具包,基于 PaddlePaddle 平台,把语音识别(ASR)、语音合成(TTS)、语音翻译、说话人验证、关键词唤醒这些能力打包在了一起。它拿过 NAACL2022 最佳演示奖,GitHub 上 12.6k star,最近还在持续更新,适合开发者快速搭一套语音功能原型。
适合谁
- 想给应用加语音能力的开发者:不管是做语音转写、文字转语音,还是做个语音唤醒的 demo,PaddleSpeech 把常用模型都封装成了命令和 Python API,不用自己从头训模型。
- 做语音方向研究的技术爱好者:仓库里集成了 SOTA 模型和自监督学习模型,可以用来做实验对比或二次开发,也方便看论文落地效果。
- 需要离线或本地部署语音服务的团队:它支持 Linux、Windows、macOS,Python 3.8+ 就能装,不想把音频数据扔给云端 API 的,可以本地跑。
能解决什么问题
- 语音识别带标点:默认支持中英文,识别结果直接带标点符号,不用自己再做后处理。输入
paddlespeech asr --input zh.wav就能看到结果。 - 文字合成语音:输入一段文字,命令生成对应的音频文件,支持中文文本前端处理,像数字、日期、温度这类格式会先做归一化再合成。
- 音频翻译和说话人验证:英文音频可以翻译成中文输出;也能做说话人验证,判断两段音频是不是同一个人,适合做声纹相关的功能。
怎么开始用
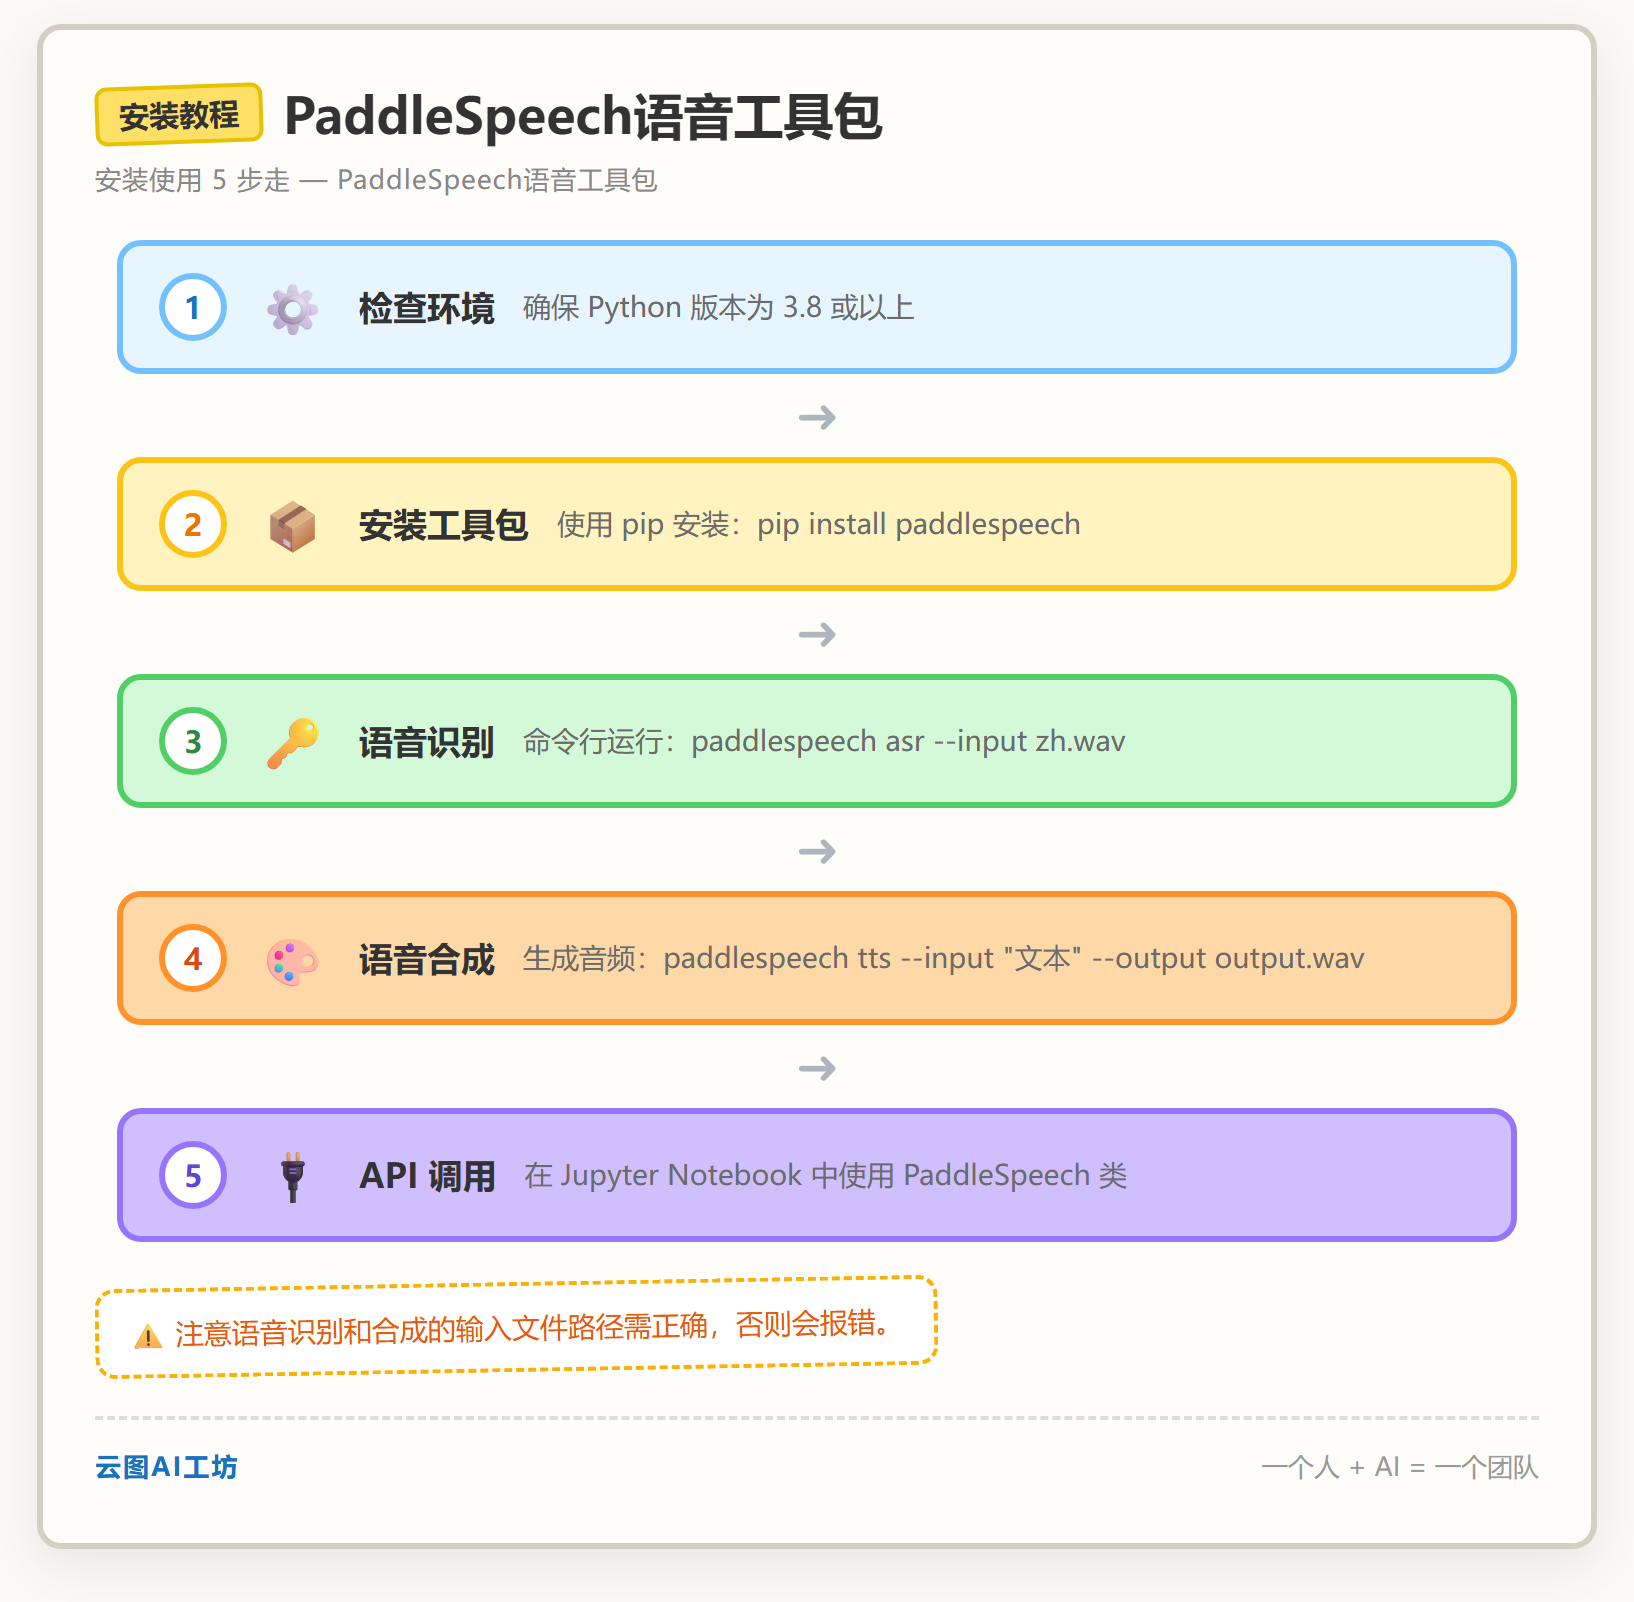
官方推荐用 pip 安装,Python 3.8 及以上版本:
pip install paddlespeech
语音识别,命令行直接跑:
paddlespeech asr --input zh.wav
语音合成,输入文字生成音频:
paddlespeech tts --input "你好,欢迎使用PaddleSpeech" --output output.wav
也可以用 Python API 调用,项目提供了 PaddleSpeech 类,支持在 Jupyter Notebook 里交互式使用。
优点和坑
优点:
- 功能覆盖全:ASR、TTS、翻译、声纹、唤醒词都在一个仓库里,模型列表很丰富,官方持续在更新。
- 中文支持好:文本前端处理对中文数字、日期、温度这些格式有专门处理,中文识别和合成效果比通用方案靠谱。
- 社区活跃:12.6k star、1.9k fork,更新频率高,文档和示例代码齐全,还有 AIStudio 课程可以跟学。
坑也不少:
- 依赖 PaddlePaddle 框架:不像一些轻量工具只装一个包就行,它绑定了整个 Paddle 生态,环境配置比纯 Python 库要重。
- 训练或调优门槛高:直接调用预训练模型容易,但想在自己数据上微调,需要熟悉 Paddle 的训练流程,对新手不算友好。
- 资源要求不低:语音模型推理和训练对 CPU/GPU 都有要求,没有 GPU 的情况下跑TTS或大规模识别会明显吃力。
- 部分模型没有预训练权重:README 里列了不少模型,但某些只是提供了配置和训练方法,需要自己下载数据训练,不是开箱即用。
适合你吗
如果你是想快速在项目里集成语音识别或合成功能的开发者,PaddleSpeech 的预训练模型和命令行工具能让你在半天内跑通一个 demo。如果你是做语音方向研究、需要可复现的 SOTA 模型的,它也是一个不错的参考实现库。
但如果你只是偶尔转一段录音,或者不想折腾 Python 环境和 Paddle 依赖,那这个工具对你来说偏重了,不如直接用在线 API 或更轻量的方案。
注意:以上所有功能描述和安装方式均来自官方 README,未经过本站实测验证;PaddleSpeech 的实际运行效果和资源占用,请以你的部署环境为准。
常见问题
PaddleSpeech能用来做语音合成吗,效果怎么样?
可以。PaddleSpeech支持文字转语音(TTS),输入文字即可生成音频文件。它对中文支持好,能对数字、日期、温度等格式做归一化处理后再合成。使用命令行工具时,输入 paddlespeech tts --input "你好" --output output.wav 即可生成音频。
使用PaddleSpeech时,如何指定或更换不同的模型?
根据正文,PaddleSpeech仓库集成了多种SOTA模型,但部分模型可能没有预训练权重,需要自己下载数据训练。对于预训练模型,通常可以通过命令行参数或Python API的配置项来指定。具体模型列表和调用方式需查阅官方文档和示例代码。
PaddleSpeech支持离线部署吗?
支持。PaddleSpeech适合需要离线或本地部署语音服务的团队。它支持Linux、Windows、macOS系统,只需Python 3.8+环境即可安装,可以在本地运行语音识别、合成等功能,无需将音频数据上传至云端API。
PaddleSpeech的语音识别准确率高吗,支持中文吗?
PaddleSpeech默认支持中英文语音识别,且识别结果直接带标点符号,无需后处理。它针对中文有专门的文本前端处理,对数字、日期等格式处理较好,因此中文识别和合成效果比通用方案更可靠。实际准确率取决于具体模型和部署环境。
PaddleSpeech是免费的吗,怎么安装?
PaddleSpeech是百度开源项目,免费使用。官方推荐使用pip安装,要求Python 3.8及以上版本。安装命令为:pip install paddlespeech。但需注意,它依赖整个PaddlePaddle框架,环境配置比纯Python库要重一些。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。