NVIDIA NeMo Speech:可扩展语音AI框架
分类:工具实测 浏览量:7
摘要:
NVIDIA NeMo Speech 是 NVIDIA 开源的语音 AI 框架,主要面向开发者和研究人员。它提供语音识别(ASR)、语音合成(TTS)和语音大模型的整套训练与推理流程,能帮助电商技术团队解决多语言语音转录、客服质检、有声书或配音生成等场景下的语音处理需求。该框架适合手头有 NVIDIA GPU、有 PyTorch 基础,并愿意投入时间学习以进行多语言 ASR 或 TTS 落地的开发团队。
NVIDIA NeMo Speech:开发者语音AI框架(ASR/TTS/语音LLM)拆解
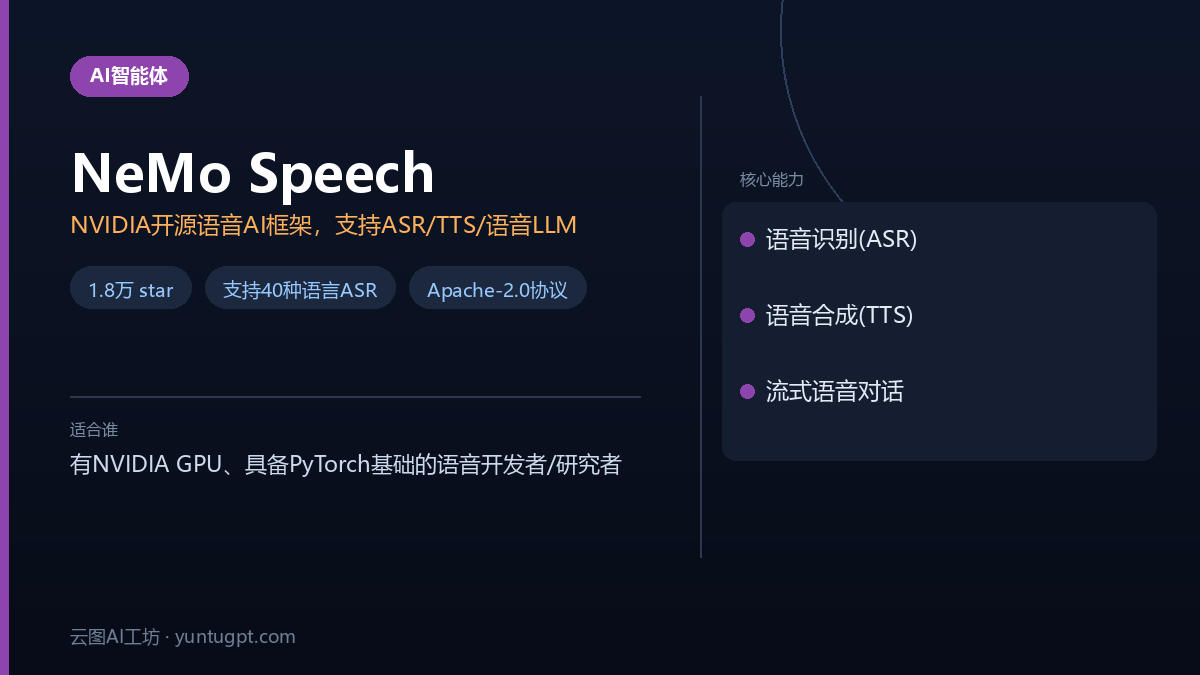
NVIDIA NeMo Speech 是 NVIDIA 开源的语音 AI 框架,主要给做语音识别(ASR)、语音合成(TTS)和语音大模型的开发者和研究人员用。它在 GitHub 上有 18573 star、3643 fork,用的是 Apache-2.0 协议,最近一次更新是 2026-10-12,项目还在持续维护。
适合谁
- 搞语音识别的开发者:需要把音频转文字,用在做字幕、会议纪要、客服质检这些地方。NeMo 提供了整套训练和推理的流程。
- 做语音合成的技术团队:要做配音、有声书、语音助手回复。项目里有多语言的 TTS 模型,可以直接用,也能自己微调。
- 折腾语音大模型的极客:仓库里还包含了语音流式推理和语音对话模型(Nemotron VoiceChat),适合想跟进这个方向的技术人员。
能解决什么问题
语音识别准确率优化:新更新的 Nemotron-3.5-ASR-Streaming 支持 40 种语言,延迟在 80ms 到 1s 之间,你可以根据需求选择要低延迟还是要高准确率。它的 Canary-Qwen-2.5B 模型在英文公开测试集上的词错误率(WER)是 5.63%,做英文转录效果不错。
多语言 TTS 配音:MagpieTTS 模型支持 12 种语言(英语、西班牙语、德语、法语、越南语、意大利语、中文、印地语、日语,2026年7月又加了阿拉伯语、韩语、葡萄牙语)。做多语言配音产品的话,能省掉自己从头训练声学模型的工作。
全流程流式 + 离线方案:Parakeet-unified 这一个模型就能同时做离线和流式推理(最低延迟 160ms),不用分别维护两套方案。
怎么开始用
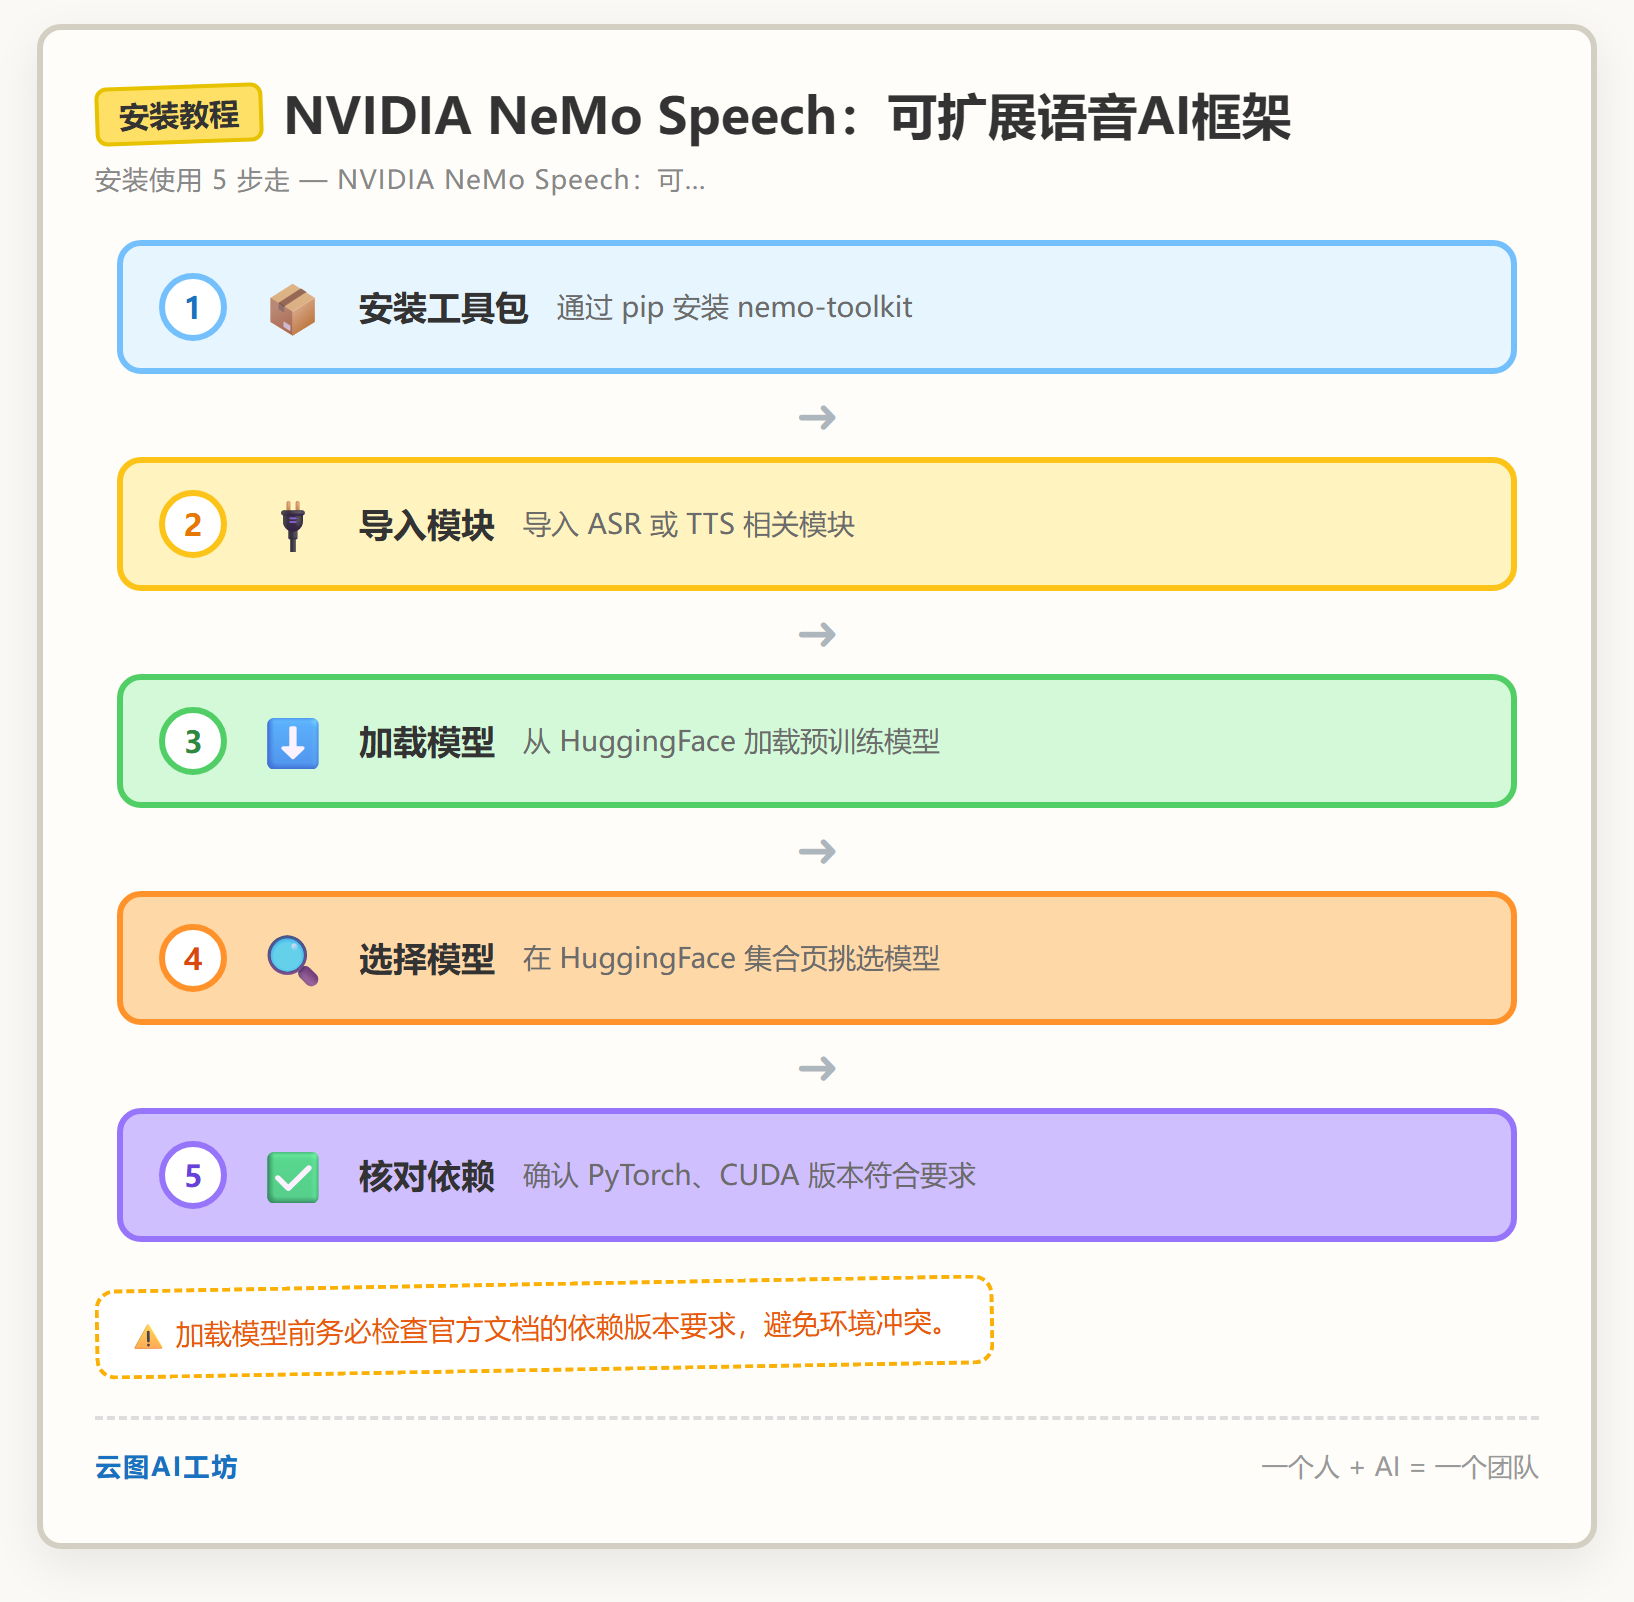
通过 pip 安装,官方命令是:
pip install nemo-toolkit
装好之后,可以直接从 HuggingFace 加载官方发布的模型权重。比如加载一个 ASR 模型:
import nemo.collections.asr as nemo_asr
asr_model = nemo_asr.models.ASRModel.from_pretrained("nvidia/parakeet-tdt-0.6b-v3")
TTS 模型也差不多,去 HuggingFace 的集合页里挑对应的模型名加载就行。具体的依赖版本(像 PyTorch、CUDA)要求,以官方文档说的为准。
优点和坑
优点:
- 模型选择多:ASR、TTS、语音翻译、语音 LLM 都有对应的模型。官方还在 HuggingFace 上维护了一个模型集合,不用到处找权重文件。
- 更新快:从 2025 年到 2026 年一直在发布新模型,社区的反馈能比较快地合并到主线。
- Apache-2.0 协议:对商业应用友好,没有 GPL 那种传染性限制。
坑:
- 硬件要求高:官方给出的并发和延迟指标(比如 240-2400 路并发流)是在 1 张 H100 显卡的环境下测的。普通开发者手里没这种卡,就别指望能复现那个性能。
- 文档多,上手慢:这个框架是给研究人员设计的,不是开箱即用的 API。想自己微调一个语音识别模型,得先弄懂 NeMo 的配置系统、数据格式和训练流程,学习曲线比较陡。
- 项目刚拆分过:这个仓库在 2026 年转向只做音频和语音,原来大模型和多模态的部分挪到别的仓库去了。如果搜 NeMo 的资料,旧的教程可能跟现在仓库的结构对不上。
- 纯 CPU 跑不动:训练和推理基本都得用 GPU。本地没有 NVIDIA 显卡的话,只能考虑用云 GPU 或者官方的 NGC 容器,部署成本得算进去。
适合你吗
适合:手头有 NVIDIA GPU、有 PyTorch 基础、愿意读文档的语音方向开发者和研究人员。如果你的团队需要做多语言 ASR 或 TTS 落地,也能接受前期的环境搭建成本,用 NeMo 的生态能省下从零开始训练的时间。
不适合:只是想写个脚本偶尔调一下语音转文字、没有 GPU、指望“pip 装完就能直接跑”的轻量用户。NeMo 的设计目标不是这种场景,你去找云 API 或者其他更轻量的方案更省事。
---
常见问题
NVIDIA NeMo Speech 能用来做什么?
NVIDIA NeMo Speech 是个开源的语音AI框架,主要给开发者用。它能做语音识别(ASR),比如把音频转成文字来生成字幕、整理会议纪要;能做语音合成(TTS),用来制作配音、有声书;还支持语音大模型和流式对话模型,适合想研究前沿语音技术的人。
NVIDIA NeMo 语音识别准确率高吗?
准确率要看具体模型。比如,它的 Canary-Qwen-2.5B 模型在英文公开测试集上的词错误率(WER)是 5.63%。另外,Nemotron-3.5-ASR-Streaming 模型支持 40 种语言,你可以在低延迟(80ms 到 1s)和高准确率之间根据场景做选择。
NVIDIA NeMo Speech 支持中文语音合成吗?
支持。它的 MagpieTTS 模型已经支持 12 种语言,里面包含中文。这意味着你可以直接用或者微调这个模型来生成中文语音,用到配音、有声书这些产品里,省掉自己从头训练声学模型的功夫。
NVIDIA NeMo 怎么安装和使用?
主要用 pip 安装。官方命令是 pip install nemo-toolkit。装好后,可以直接从 HuggingFace 加载预训练好的模型权重。举个例子,加载一个 ASR 模型的代码是:import nemo.collections.asr as nemo_asr; asr_model = nemo_asr.models.ASRModel.from_pretrained("nvidia/parakeet-tdt-0.6b-v3")。具体的依赖版本要求得看官方文档。
用 NVIDIA NeMo 需要什么硬件?免费吗?
项目用的是 Apache-2.0 协议,商业用途免费。但对硬件有要求,训练和推理基本都得用 NVIDIA GPU。官方标出的高性能指标(比如 240-2400 路并发流)是在 1 张 H100 显卡的环境下测的。如果没有 GPU,只能考虑用云 GPU 或者官方的 NGC 容器,纯 CPU 环境不适合运行。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。