Mozilla TTS:本地部署的深度学习文本转语音库
分类:工具实测 浏览量:57
摘要:
Mozilla TTS是一个基于深度学习的开源文本转语音库,为开发者和研究者提供可训练、可本地部署的语音合成解决方案。它能帮助电商技术团队解决私有化语音合成需求,避免数据外泄,并支持训练自定义音色的语音模型,适用于有声书、语音助手、客服机器人等场景。该工具主要适合三类人群:需要本地部署语音引擎的后端工程师、研究语音方向的学生或研究员,以及希望在本地体验TTS的技术爱好者。
开源TTS工具给谁用?先看一个背景
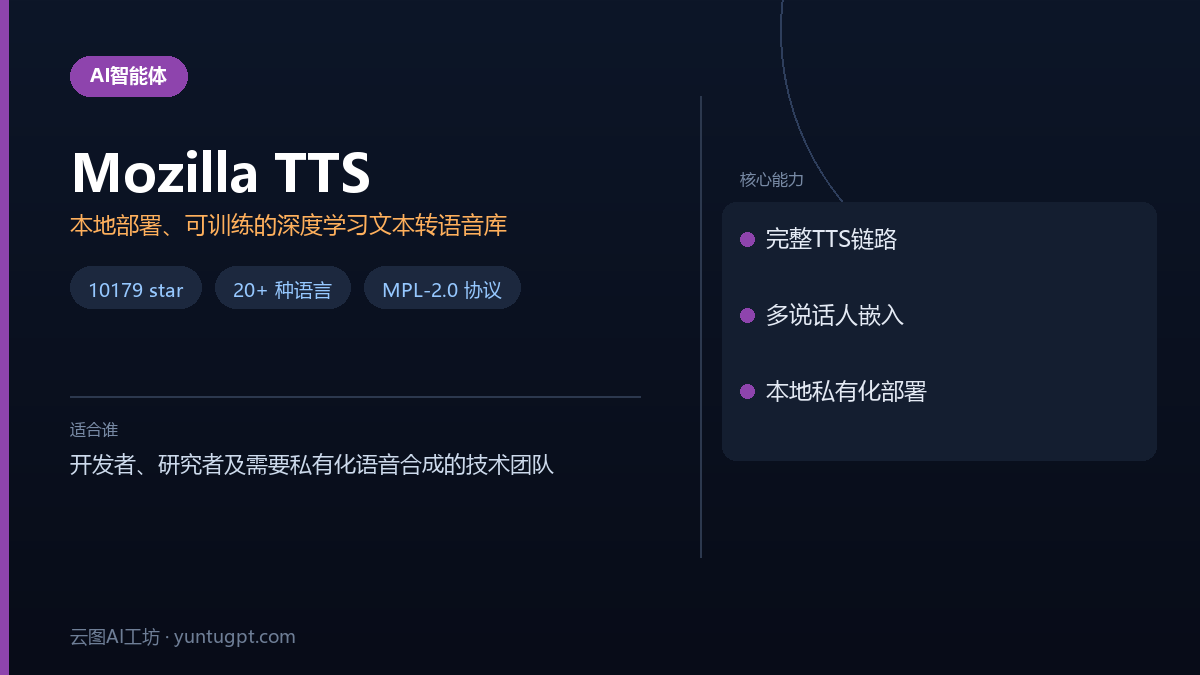
Mozilla TTS(GitHub 仓库名 mozilla/TTS,star 10179)是一个基于深度学习的文本转语音库。官方描述定位很明确:为开发者和研究者提供训练速度快、生成质量高、易于扩展的 TTS 引擎。它支持20+ 种语言,内置了从文本到频谱(Tacotron、Tacotron2、Glow-TTS、SpeedySpeech)再到声码器(MelGAN、WaveRNN、ParallelWaveGAN)的完整链路,还带 Speaker Encoder 可以做多说话人声音嵌入。对技术人来说,它不是一个开箱即用的小工具,而是一套可以自己训练、部署、调优的语音合成解决方案。
适合谁
开发者或技术爱好者主要分三类人适合碰这个项目。
第一类:做语音类产品的后端工程师。比如你在做有声书、语音助手、客服机器人,需要一个能本地部署、可私有化的语音合成引擎,不希望每次都调用云端付费 API。Mozilla TTS 提供了从训练到推理的完整管线,模型可以导出为 PyTorch、TensorFlow 和 TFLite 格式,方便嵌入到不同端侧环境。
第二类:研究语音方向的学生或研究员。项目代码结构是"模块化但不过度抽象",论文实现(Tacotron2、Glow-TTS、MelGAN 等)直接对应到代码,方便做 baseline 对比和消融实验。官方还维护了一个论文合集仓库和训练 recipe 库,省去自己翻论文找实现的时间。
第三类:技术折腾党。想在自己电脑上体验本地 TTS,或者想给开源社区贡献代码,这个项目有 10179 个 star,社区活跃度足够,issue 和 discourse 讨论区都有专人维护,踩坑时能找到帮助。
如果你是完全没有编程基础的普通人,只是想快速把文字变成语音文件,这个项目不适合你——后面会说原因。
能解决什么问题
场景一:私有化语音合成,避免数据外泄。 很多场景(比如内部培训语音、产品语音提示)不希望把文本内容发送到第三方 API。Mozilla TTS 可以完全离线运行,训练和推理都在本地完成。官方提供预训练模型下载,普通开发者不需要自己训练就能跑通基础 TTS。
场景二:训练自定义音色的语音模型。 项目支持多说话人 TTS,配合 Speaker Encoder 可以计算说话人嵌入向量。如果你有特定人的录音数据(比如公司需要合成特定主播的声音),可以用这些数据微调模型。训练日志会输出到控制台和 Tensorboard,方便监控训练过程。
场景三:批量合成大量文本语音。 提供了命令行推理接口,可以用 released models 在终端直接合成语音。对于需要批量生成音频文件的开发者(比如批量生成语音导航包、课程音频),可以写脚本批量调用。
场景四:做 TTS 数据集的质检工具。 项目提供了 dataset_analysis 工具集,用来衡量数据集质量。如果你手里有一批语音数据,不确定标注是否准确、时长分布是否合理,可以用它来分析。
怎么开始用
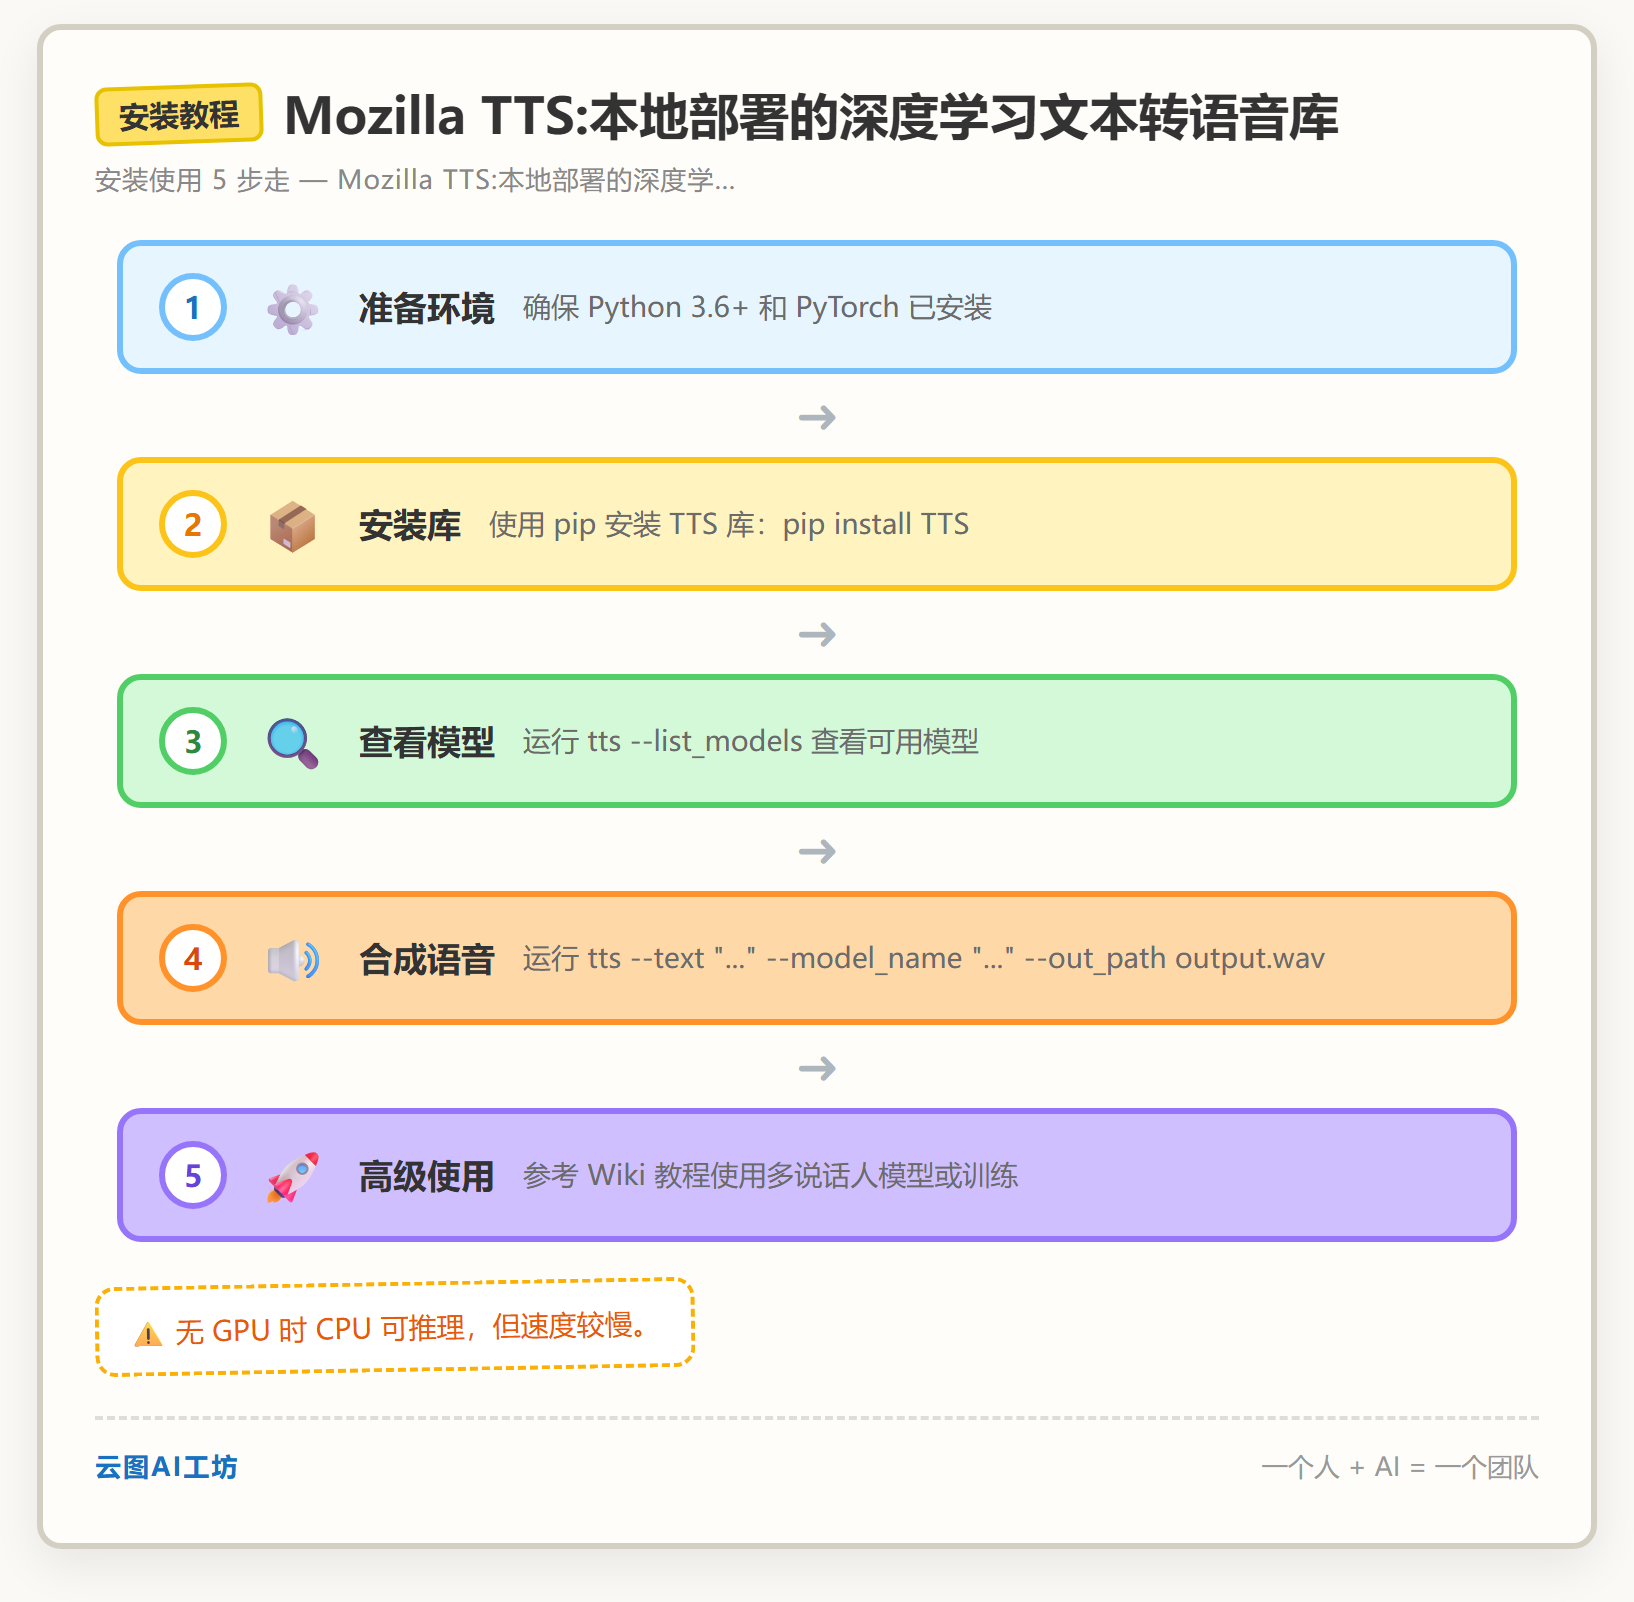
官方推荐先通过 pip 安装,再下载预训练模型跑通第一个 demo。
# 安装 TTS 库
pip install TTS

# 查看可用命令
tts --list_models
跑一个最基础的合成任务,在终端里直接指定要合成的文本和模型:
# 使用预训练模型合成语音,保存到 output.wav
tts --text "This is a test sentence." --model_name "tts_models/en/ljspeech/tacotron2-DDC" --vocoder_name "vocoder_models/en/ljspeech/multiband-melgan" --out_path output.wav
如果你要用多说话人模型,需要在命令行里提供说话人 ID 或参考音频。更详细的用法(训练自己的模型、评测模型质量)在项目 wiki 的 Tutorials and Examples 页面有介绍,仓库也提供了 Docker 镜像(由社区成员 @synesthesiam 维护)和演示服务器(TTS/server),可以快速启动一个 Web 界面测试多个模型的效果。
注意: 上面的命令是基于 README 里提供的终端合成示例。实际跑通需要 Python 3.6+ 环境,且依赖 PyTorch。如果你的机器没有 GPU,CPU 也能推理,但速度会慢不少。
优点和坑
优点:
1. 模型覆盖完整,链路不用自己拼。 从文本到频谱的模型(Tacotron、Tacotron2、Glow-TTS、SpeedySpeech)到声码器(MelGAN、Multiband-MelGAN、GAN-TTS、ParallelWaveGAN、WaveGrad、WaveRNN)都内置了,不用自己单独找声码器搭链路。
2. 训练代码和推理接口都有,落地路径清晰。 官方提供了多 GPU 训练支持、Tensorboard 日志、模型导出为 TensorFlow/TFLite 的工具,适合从研究到产品化过渡。
3. 社区活跃,资源丰富。 有 10179 个 star、1319 个 fork,官方还维护了示例音频页面(English Voice Samples)和训练 recipe 库(TTS_recipes),新手可以直接照着 recipe 跑通训练流程。
坑(真实限制):
1. 安装和依赖是门槛。 这本质是一个深度学习训练库,依赖 PyTorch 和一堆关联包。如果你没配过深度学习环境,装依赖可能会卡一阵子。README 的安装说明是给开发者看的技术文档,没有图形化向导。
2. 训练模型需要 GPU 和足够多的数据。 官方虽然提供了预训练模型,但如果你想训练自己的音色(特别是中文),需要准备对应语种的语音数据集。TTS 项目目前支持 20+ 种语言,但中文的预训练模型资源比英文少,动手训练的话需要较强的硬件(显存是关键,多 GPU 训练是官方推荐的模式,单显卡训练会比较吃力)。
3. 推理质量依赖模型选择和调参。 不是装好就能达到自然流畅的效果——需要选择合适的模型组合(频谱模型 + 声码器搭配不同,听感差异很大),官方提供了 Mean Opinion Score(MOS)评测结果对比图谱,但那是针对特定模型和数据集的,换到你的场景不一定同样表现。
4. MPL-2.0 协议,商用要留意。 项目采用 MPL-2.0 协议,如果你要闭源商用,需要了解该协议的条款边界(尤其是修改过的源文件需要保持开源)。这不是法律意见,但商用前建议和法务确认。
适合你吗
适合: 有 Python 开发经验、想搭本地 TTS 服务、愿意折腾模型和训练参数的开发者;做语音方向的科研人员需要对比多个模型实现;想要脱离第三方云 API、实现完全私有化语音生成的技术团队。
不适合: 没有编程基础、只想快速拿一段文字生成语音的人——直接用在线 TTS 工具(比如微软 Azure 的免费额度)更省事,Mozilla TTS 的门槛不值得为了一个小需求去踩一遍环境配置和模型调试。另外,如果你的需求是中文高质量合成,需要先验证社区提供的中文预训练模型效果是否满足要求——官方明确说支持 20+ 语种,但效果和英文相比存在差距,这一点建议自己带着样本去官方示例音频页面听一下对比。
---
常见问题
Mozilla TTS 是免费的吗?
是的,Mozilla TTS 是完全免费的开源项目,遵循 MPL-2.0 开源协议。你可以免费下载、使用、修改和部署它。不过,如果你计划将修改后的代码用于闭源商业产品,需要仔细阅读 MPL-2.0 协议条款,因为修改过的源文件可能需要保持开源,建议商用前咨询法务。
Mozilla TTS 怎么安装?
安装主要通过 pip 进行。首先确保你的环境是 Python 3.6+ 并安装了 PyTorch,然后在终端运行命令 pip install TTS 即可安装库。安装后,可以通过 tts --list_models 查看可用的预训练模型。这是一个深度学习库,对没有配置过相关环境的用户来说,安装依赖可能有一定门槛。
Mozilla TTS 支持中文吗?准确率怎么样?
支持,Mozilla TTS 官方宣称支持 20+ 种语言,包括中文。但需要注意,其中文的预训练模型资源比英文少,合成效果与英文相比可能存在差距。官方提供了示例音频页面供试听对比。如果你需要高质量中文合成,可能需要用自己的中文数据集进行训练或微调模型。
Mozilla TTS 和在线 TTS 工具(比如微软 Azure)比有什么优势?
主要优势在于可以完全本地部署和私有化,避免数据外泄。它适合需要批量合成、定制音色或对数据隐私要求高的场景,如内部培训语音、客服机器人。而像微软 Azure 这类在线 API 则更适合没有编程基础、想快速生成少量语音的用户,它们通常开箱即用,但依赖网络且有使用成本。
运行 Mozilla TTS 需要什么配置?
推理可以在 CPU 上进行,但速度较慢。为了获得较好体验,特别是进行模型训练时,官方推荐使用 GPU。训练自定义音色模型需要较强的硬件,显存是关键,并且官方推荐多 GPU 训练模式。同时,你需要准备对应语种(如中文)的足够量的语音数据集。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。