Scrapegraph AI:AI驱动的商品信息抓取工具
分类:工具实测 浏览量:8
摘要:
Scrapegraph AI 是一个基于 Python 的 AI 驱动网页信息抓取库。它通过自然语言指令,自动分析并提取指定网页中的商品标题、价格、销量、参数及用户评价等信息,将结果整理为 JSON 或 Excel 文件。该工具主要帮助电商从业者解决竞品分析、商品信息同步和市场趋势调研等耗时问题,将原本数小时的手动工作缩短至几分钟。它尤其适合需要进行市场调研的店主、负责维护商品信息的小团队以及希望分析行业趋势的卖家。
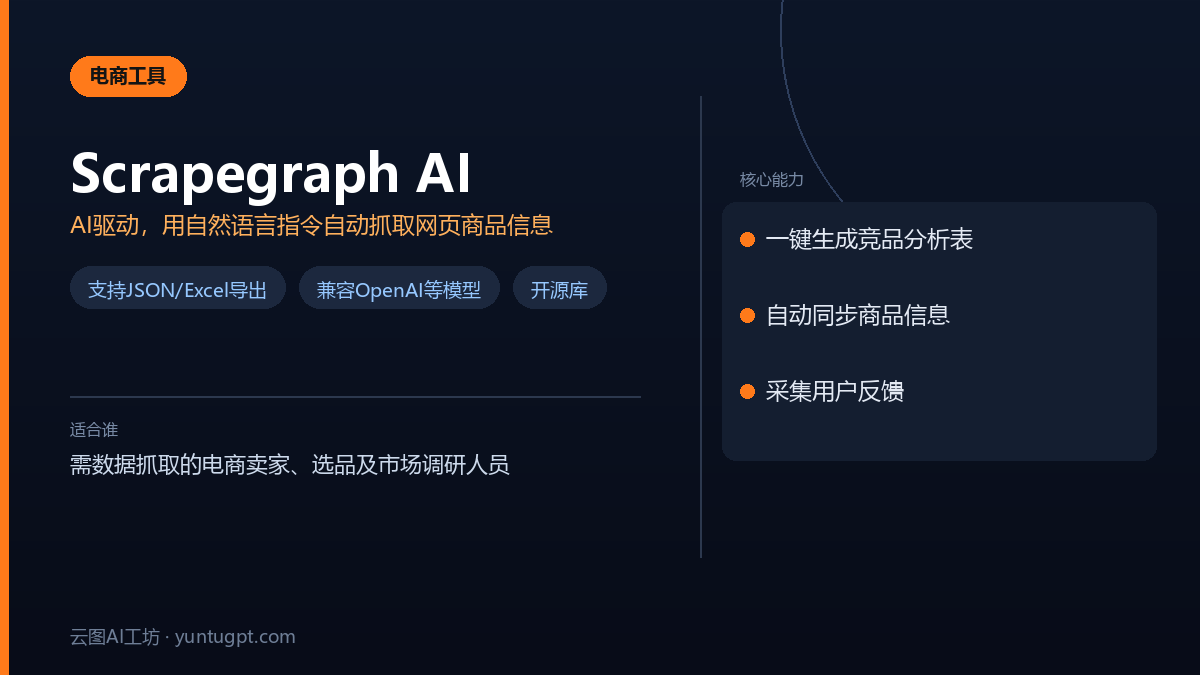
Scrapegraph AI 是个 Python 库,用 AI 自动抓网页信息。你告诉它从哪个网页找什么,它自己分析页面,把结果整理出来,省去手动复制粘贴。
适合谁
第一类是需要做选品和市场调研的店主。想了解其他店铺卖什么、价格多少、评价怎么样,一页页翻太慢。这个工具能快速抓取竞品信息,整理成表格方便对比。
第二类是需要维护商品信息的小团队。比如代理一个品牌,产品参数和描述经常更新。可以用它定期抓取官网最新数据,同步到自己店铺后台,防止信息过期。
第三类是想分析行业趋势的卖家。用它批量抓取平台热搜词、榜单商品或者行业报告数据,为备货和营销提供参考。
能解决什么问题
1. 一键生成竞品分析表
以前得打开十几个竞品链接,自己记下标题、价格、销量、主图、卖点。现在,你准备一个竞品链接列表,写一句像“抓取每个页面的商品标题、当前售价、月销量和核心产品参数”这样的指令,工具就能跑完所有链接,把结果整理成 JSON 或 Excel 文件。整个过程从几小时缩短到几分钟。
2. 自动同步商品信息与价格
假设你在淘宝和抖音都有店,或者代理了多个供应商的商品。可以设置定时任务,每周用 Scrapegraph AI 抓取供应商官网的最新价格和库存状态,跟你店铺后台的数据比对。发现价格变动或库存紧张,系统就能提醒你更新,避免超卖或标错价。
3. 快速采集用户反馈与市场声音
想知道某类产品的用户主要在吐槽什么。让它去抓取社交媒体或评价区的内容,指令可以是:“从以下页面中,提取所有用户评论,并总结出关于‘电池续航’和‘屏幕质量’的正面与负面评价点。” 它不仅能抓原文,还能用 AI 初步归纳,帮你快速抓住市场痛点。
怎么开始用
先确保有一个能运行 Python 的环境。打开命令行,按顺序输入下面命令来安装和配置。
# 1. 安装 Scrapegraph AI 库
pip install scrapegraphai

# 2. 安装浏览器驱动(用于抓取网页内容,这一步必须做)
playwright install
装好后,创建一个 Python 文件(比如叫 `scrape_product.py`),把下面的代码复制进去。需要改两个地方:一是换成你自己的 OpenAI API 密钥,二是把 `source` 后面的网址换成你要抓取的商品页。
from scrapegraphai.graphs import SmartScraperGraph

# 配置 AI 模型,这里用 OpenAI 的模型,你也可以用其他支持的模型
graph_config = {
    "llm": {
        "api_key": "YOUR_OPENAI_API_KEY",  # 这里换成你的真实 API Key
        "model": "openai/gpt-4o-mini",
    },
    "verbose": True,
    "headless": False,  # 设为 True 则后台运行不显示浏览器窗口
}

# 创建抓取实例
smart_scraper_graph = SmartScraperGraph(
    prompt="提取这个商品页面的信息,包括商品标题、价格、销量、主要产品特性和用户评价摘要。",
    source="https://example.com/product-page",  # 这里换成你想抓取的商品链接
    config=graph_config
)

# 运行抓取
result = smart_scraper_graph.run()

# 打印结果
import json
print(json.dumps(result, indent=4))
运行这个脚本,控制台就会显示提取好的商品信息。
优点和坑
优点有这些:
第一是智能化。不像传统爬虫要写复杂规则定位网页元素,你用人话说需求,AI 来理解和执行,对付结构常变的电商页面更省事。
第二是省时间。把重复、繁琐的数据收集工作自动化,你可以更集中精力做选品和运营策略。
但也有几个坑要注意:
1. 部署有门槛:代码虽然只有几行,但要求你会一点 Python,能在自己电脑或服务器上配好环境。完全没碰过命令行的,第一步可能就卡住。
2. 需要 API 密钥和费用:想用效果好的 GPT-4 这类模型,得自己准备 OpenAI 等平台的 API 密钥,并且会产生使用费。项目也支持免费的本地模型(比如 Ollama),但效果和速度可能差一些。
3. 资源要求不低:大量抓取或处理复杂页面时,对电脑性能和网络稳定性有要求。抓取频率太高,还可能触发目标网站的反爬机制,导致 IP 被限制。
4. 不是万能的:它主要擅长从相对规整的页面提取信息。如果信息藏在需要复杂交互(比如多次点击、登录)才能看到的地方,或者页面是纯图片、复杂验证码,它可能就处理不了。
适合你吗
如果你不排斥技术、愿意折腾一下命令行,而且日常有稳定的数据抓取需求,Scrapegraph AI 可以帮你把市场调研、竞品监控这些工作自动化。
但如果你对电脑操作很陌生,看到代码就头疼,或者只是偶尔需要抓一两个页面的数据,那手动复制粘贴,或者找一些更简单的现成浏览器插件可能更直接。它更适合批量化和自动化场景,单次使用的学习成本仍需要考虑。
另外,对数据抓取的稳定性和法律合规性要求很高的大公司,这款开源工具可能更适合做原型验证或辅助,不适合当核心生产系统。
常见问题
Scrapegraph AI 怎么安装?
安装分两步。先在命令行运行 `pip install scrapegraphai` 安装核心库。然后必须运行 `playwright install` 来装浏览器驱动,这样才能正常抓取网页。整个过程需要你有基本的 Python 环境和命令行操作能力。
Scrapegraph AI 是免费的吗?
Scrapegraph AI 库本身是开源的,但用它的核心 AI 功能需要 API 密钥,可能会产生费用。比如,用效果比较好的 OpenAI GPT-4 这类模型,需要自己准备 API 密钥并按使用量付费。项目也支持免费的本地模型(比如 Ollama),但效果和速度可能没那么好。
Scrapegraph AI 能抓取电商竞品信息吗?
可以,这是它的主要用途之一。你提供一个竞品链接列表和一句像“抓取商品标题、售价、月销量和参数”这样的指令,它就能自动分析页面,把结果整理成 JSON 或 Excel 文件,把几小时的手动工作缩短到几分钟,快速做出竞品分析表。
Scrapegraph AI 和传统爬虫有什么区别?
主要区别是更智能。传统爬虫需要你写复杂规则定位网页元素,而 Scrapegraph AI 允许你用自然语言描述需求(比如“提取标题、价格、评价”),由 AI 来理解和执行,能更好地应付结构经常变化的电商页面,省了编写和维护解析规则的时间。
用 Scrapegraph AI 抓取数据有什么限制?
主要有几个限制:1. 处理不了需要复杂交互(比如多次点击、登录)才能看到的信息。2. 对纯图片、复杂验证码页面没办法。3. 大量抓取可能触发目标网站反爬机制,导致 IP 被限。4. 需要一定的电脑性能和网络稳定性。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。