Voice-Pro:开源语音识别翻译配音一体工具箱
分类:工具实测 浏览量:5
摘要:
Voice-Pro是一款开源免费的本地化语音处理工具箱,集成了YouTube视频下载、人声分离、语音识别、翻译、文字转语音和声音克隆等多种功能。它主要帮助视频创作者、自媒体和播客主解决多语言视频翻译配音、生成字幕、制作播客文本及克隆声音等需求,将原本需要多个付费工具串联的工作流整合在一个网页界面中。该工具适合拥有NVIDIA GPU的Windows用户,以及愿意自行配置环境、希望节省订阅费用的开发者和技术型创作者使用。
创作者语音合成与克隆工具箱:Voice-Pro 开源方案拆解
做视频内容的人都知道,配音、翻译、克隆声音这些活儿,以前要么花钱找外包,要么用 ElevenLabs 这类付费服务,一个月下来成本不低。今天聊的 Voice-Pro 是一个开源工具,把 YouTube 下载、人声分离、语音识别、翻译、文字转语音、声音克隆全塞进一个网页界面里,对创作者和开发者来说,等于把一套付费工作流搬到了本地。
这个项目在 GitHub 上有 13006 star,最近更新到 2026 年 10 月,协议是 GPL-3.0,意味着你可以免费使用甚至修改它。下面从实际使用的角度拆一拆它到底能干什么、怎么上手、有哪些坑。
适合谁
视频创作者 / 自媒体:需要给视频做多语言配音、生成字幕、翻译 YouTube 内容的人。以前这些活儿要拼三四个工具,现在一个界面全搞定。
播客主:做人声分离(把背景音乐和人声分开)、语音转文字做 shownotes、或者用克隆声音做多语言版本,都是高频操作。
开发者 / AI 爱好者:想本地跑 Whisper 语音识别、F5-TTS 声音克隆这类模型的,这个项目把模型封装成了 Gradio WebUI,不用自己写前端。
能解决什么问题
多语言视频翻译与配音:下载 YouTube 视频 → 语音识别成文字 → 翻译成目标语言 → 用 TTS 生成配音。整个流程在同一个界面里完成,不用来回导文件。
声音克隆:提供 F5-TTS、E2-TTS、CosyVoice 三种零样本克隆方案,录几秒参考音频就能合成新语音。对做有声书、角色配音、多语言版本视频的人来说,省了重新录音的成本。
音频处理:内置 Demucs 人声分离和 MDX-Net,可以把一首歌里的人声和伴奏分开,或者把视频里的环境噪音去掉。语音识别方面有 Whisper、Faster-Whisper、Whisper-Timestamped 三套可选,带时间戳的输出对做字幕特别有用。
怎么开始用
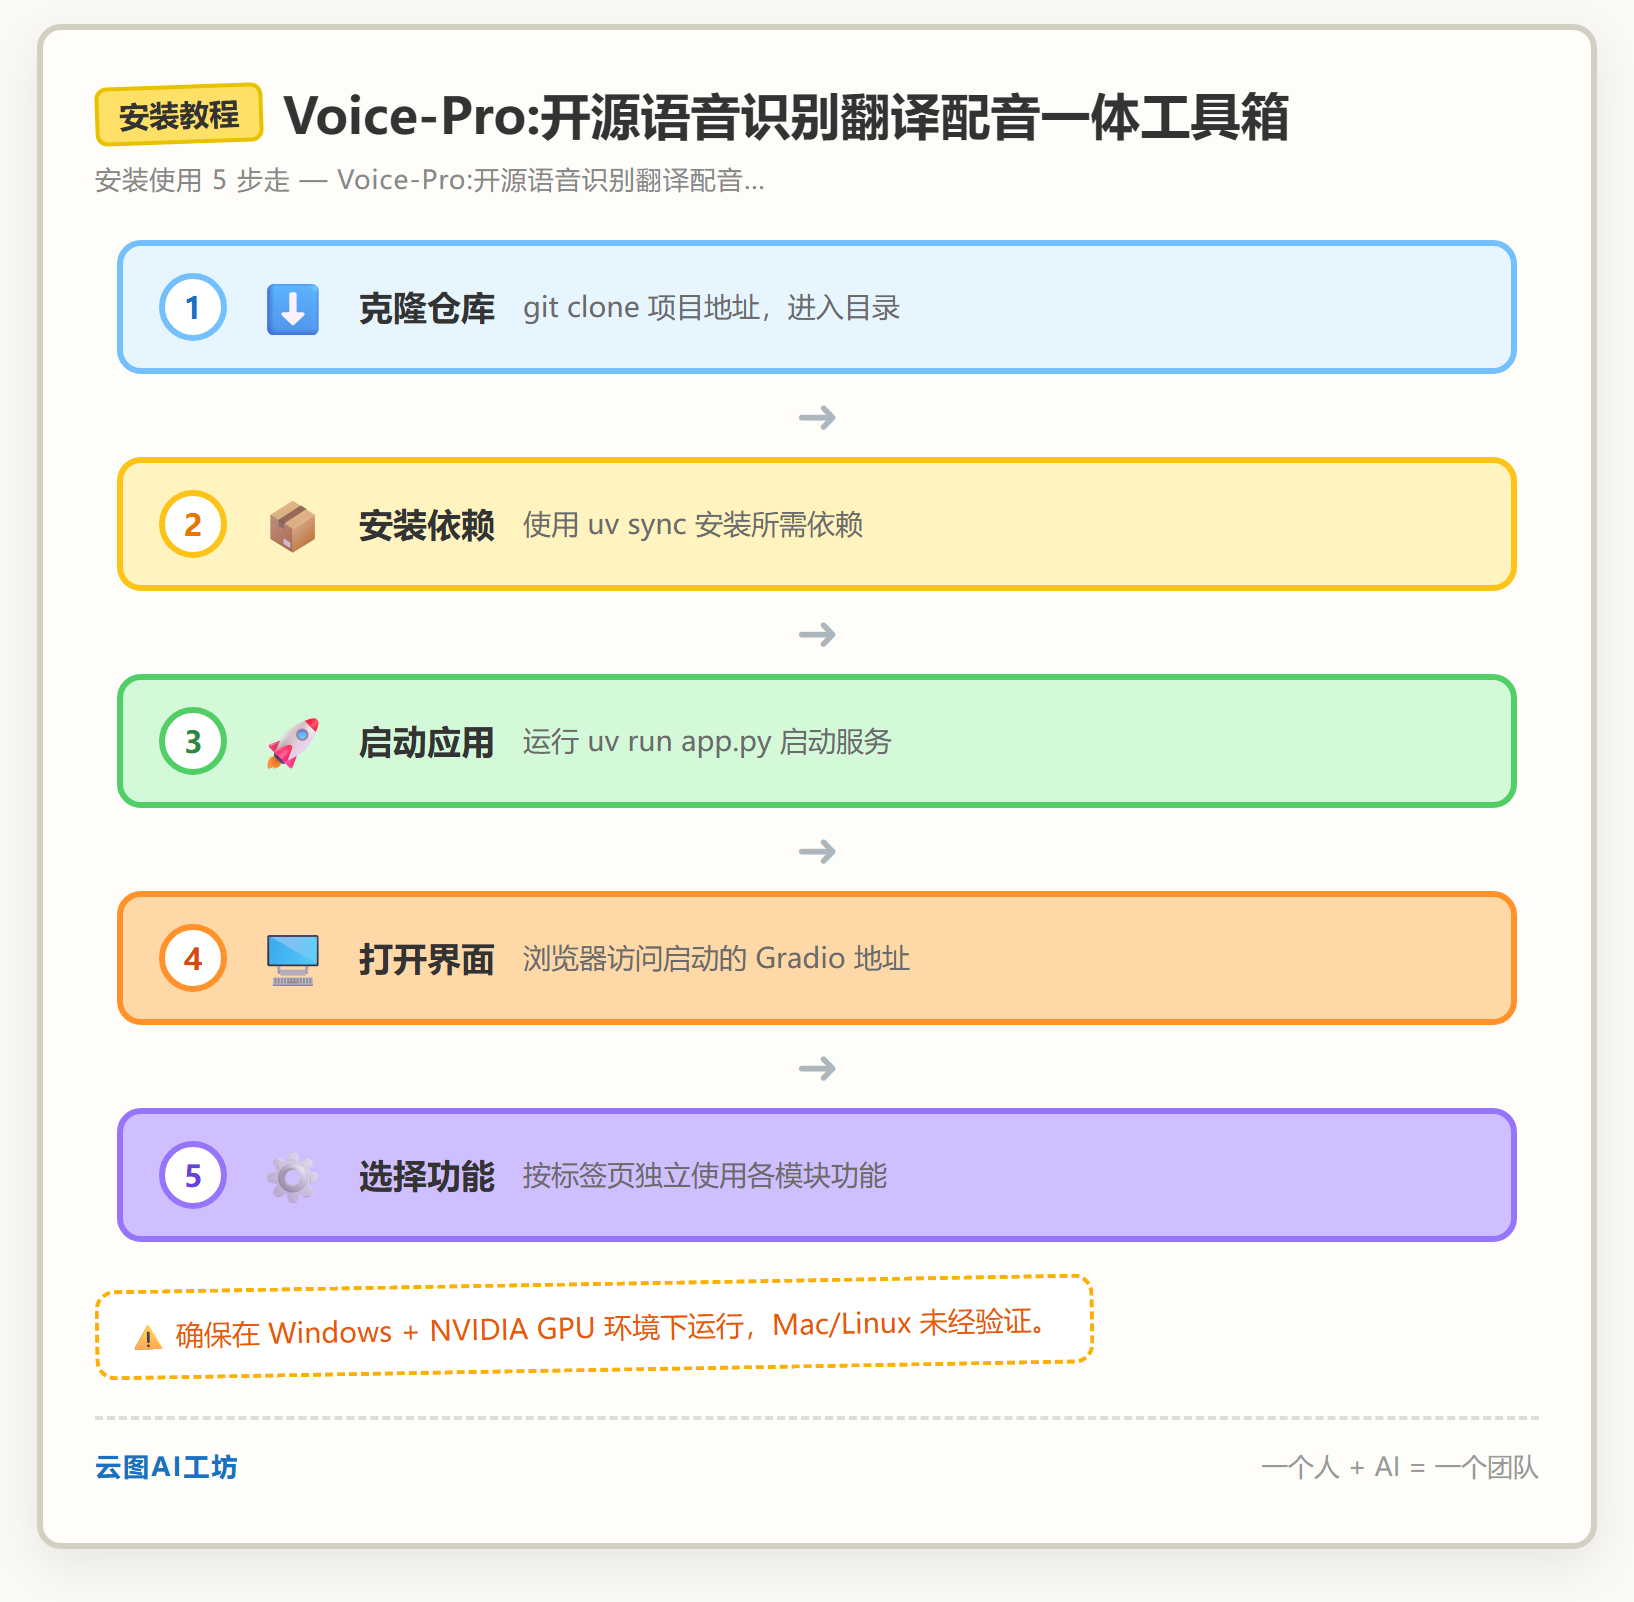
项目官方说在 Windows + NVIDIA GPU 上运行良好,Mac 和 Linux 未验证。安装方式在 README 里有完整说明,核心步骤是:
# 克隆仓库
git clone https://github.com/abus-aikorea/voice-pro.git
cd voice-pro

# 安装依赖(推荐使用 uv)
uv sync

# 启动 WebUI
uv run app.py
启动后浏览器打开 Gradio 界面,按标签页选功能:下载视频、分离人声、识别字幕、翻译、克隆声音,每个模块都是独立的,不用一次性全跑。
优点和坑
优点:
1. 功能全:从视频下载到声音克隆,一条链路覆盖,不用在多个工具之间切换。
2. 开源免费:GPL-3.0 协议,代码全开放,没有隐藏收费。官方明确说可以自由分发和修改。
3. 模型可选:TTS 有 Edge-TTS 和 kokoro,克隆有 F5/E2/CosyVoice,识别有 Whisper 系列,按需选,不用全家桶。
坑:
1. 硬件门槛不低:官方只验证了 Windows + NVIDIA GPU。没有 N 卡的用户大概率跑不动克隆和识别模型,CPU 模式会非常慢。
2. 部署有难度:依赖 CUDA、uv、多个模型文件,对不熟悉命令行的人来说,光装环境就可能卡住。README 里的 troubleshooting 建议删掉 install 目录重装,说明环境问题不罕见。
3. 开发暂停:官方公告说因为 WeConnect 项目,Voice-Pro 暂时停止更新。虽然代码开源了,但后续 bug 修复和新功能可能要等社区贡献。
4. Mac/Linux 未验证:如果你不是 Windows 用户,大概率会遇到兼容性问题,需要自己折腾。
适合你吗
适合:有 NVIDIA GPU 的 Windows 用户,愿意花时间配置环境,想省掉 ElevenLabs 订阅费的创作者或开发者。功能集成度高,一个界面解决配音、翻译、克隆三件事。
不适合:没有独显的笔记本用户、不想碰命令行的纯小白、需要稳定售后支持的生产环境。另外,如果你只想要单一功能(比如只做声音克隆),有更轻量的替代方案,不用装这么大一个全家桶。
一句话总结:Voice-Pro 是功能齐全的开源语音工作台,但它是给愿意折腾的人准备的。配置好之后确实能省不少钱,但配置过程本身需要一点技术底子。
---
常见问题
Voice-Pro 这个工具是免费的吗?
是的,Voice-Pro 是完全免费的开源工具。它采用 GPL-3.0 协议,代码完全开放,你可以免费使用、修改甚至分发,官方明确表示没有隐藏收费。这相当于将 ElevenLabs 这类付费服务的工作流程搬到了本地。
Voice-Pro 怎么安装和配置?
安装 Voice-Pro 需要一定的技术基础。核心步骤是:克隆 GitHub 仓库,使用 uv 工具安装依赖,然后运行 app.py 启动 Web 界面。项目官方只验证了 Windows + NVIDIA GPU 环境,Mac 和 Linux 用户可能会遇到兼容性问题,需要自行解决。
Voice-Pro 的语音识别准确率怎么样?
Voice-Pro 在语音识别方面提供了 Whisper、Faster-Whisper 和 Whisper-Timestamped 三套模型可选。其中 Whisper 模型以其高准确率著称,带时间戳的输出对于制作字幕特别有用。你可以根据需求在界面中选择不同的模型。
Voice-Pro 和 ElevenLabs 这类工具有什么区别?
主要区别在于 Voice-Pro 是开源免费的本地化工具箱,集成了下载、人声分离、识别、翻译、TTS 和声音克隆等多种功能。而 ElevenLabs 是付费的在线服务。Voice-Pro 功能更全但需要自行部署,对硬件(需 NVIDIA GPU)和技术有一定要求。
用 Voice-Pro 做声音克隆需要什么条件?
使用 Voice-Pro 进行声音克隆,官方推荐 Windows 系统并配备 NVIDIA GPU,否则克隆和识别模型可能无法运行或速度极慢。它提供 F5-TTS、E2-TTS、CosyVoice 三种零样本克隆方案,只需录制几秒参考音频即可合成新语音。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。