Real-Time-Voice-Cloning:实时语音克隆开源项目解析
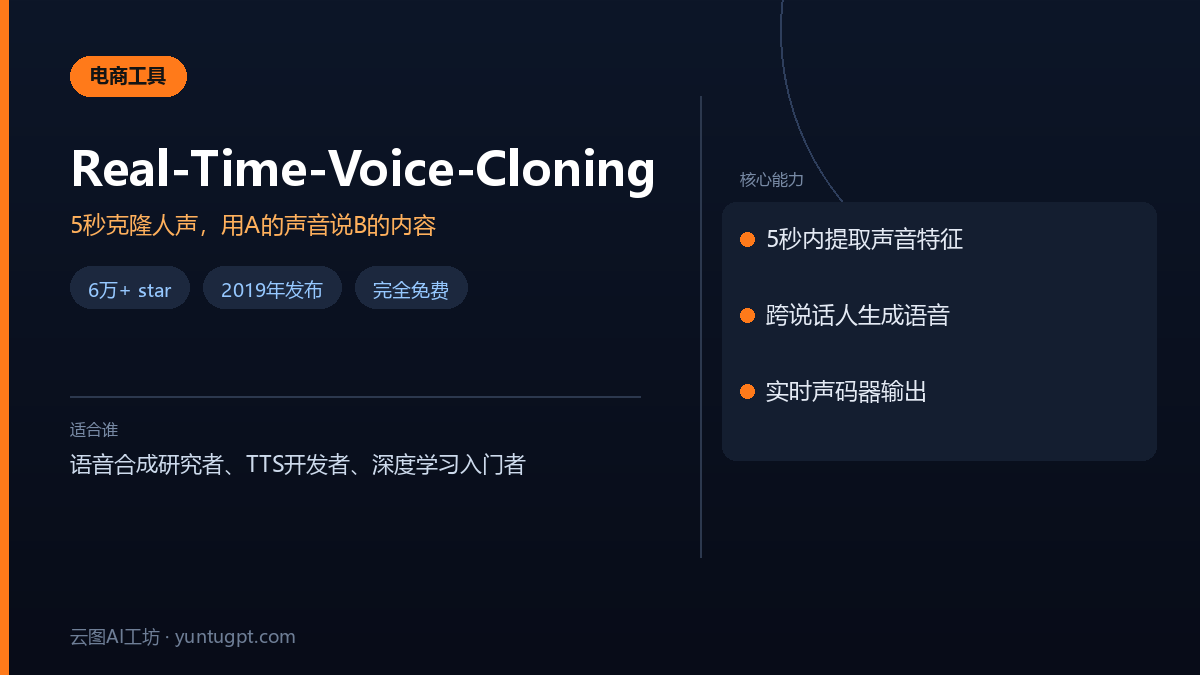
Real-Time-Voice-Cloning(简称 SV2TTS)是一个 2019 年发布的开源语音克隆项目,基于深度学习,在 GitHub 上有 60143 个 star、9382 次 fork。它用几秒钟的音频样本提取声音特征,然后结合任意文本生成对应的语音。这个项目给开发者提供了一套完整的语音合成与声音克隆参考实现,底层原理覆盖了三篇学术论文。
适合谁
语音合成研究者。项目把 SV2TTS 框架拆成了三个独立阶段:语音编码器、合成器、声码器。每个模块都对应一篇论文的实现(GE2E 编码器、Tacotron 合成器、WaveRNN 声码器),适合想对照论文做实验的技术人员。
TTS 应用开发者。如果你需要在应用里加入语音克隆能力,这个仓库可以当作基线方案。官方提供了带图形界面的工具箱和命令行两种调用方式,方便验证效果。
深度学习入门者。项目结构清晰,依赖管理用 uv 自动处理,对想理解“从说话人验证迁移到多说话人语音合成”这个思路的人来说,是很好的学习材料。
能解决什么问题
从短音频提取声音特征。编码器能把几秒钟的人声转换成固定维度的向量,这是后续语音生成的基础。官方说法是“5 秒内克隆一个声音”。
跨说话人生成语音。合成器利用提取到的声音特征,把任意文本转成对应的语音波形。也就是说,用 A 的声音特征加上 B 说的话,输出就是 A 的声音在读 B 的内容。
实时声码器输出。WaveRNN 声码器的设计目标是在实时条件下工作,这也是项目名称里 “Real-Time” 的由来。
怎么开始用
支持 Windows 和 Linux。需要先安装 ffmpeg 和 uv。用命令行检查 ffmpeg 是否已安装:
ffmpeg
安装 uv:
# Windows:
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"

# Linux:
curl -LsSf https://astral.sh/uv/install.sh | sh

# 有 pip 的话也可以直接:
pip install -U uv
运行带图形界面的工具箱:
# 有 NVIDIA GPU:
uv run --extra cuda demo_toolbox.py

# 纯 CPU 环境:
uv run --extra cpu demo_toolbox.py
不用图形界面、走命令行:
uv run --extra cuda demo_cli.py
uv run --extra cpu demo_cli.py
uv 会自动创建 .venv 虚拟环境并装好依赖。预训练模型会自动下载,如果失败也可以从 Hugging Face 手动下载。
优点和坑
优点
- 完整实现三个模块:编码器、合成器、声码器都在一个仓库里,跑起来就能看到全流程
- star 数说明认可度:60143 个 star,说明这是语音克隆领域被广泛参考的开源项目
- 安装依赖自动化:uv 自动处理 Python 环境,不用手动折腾虚拟环境和包版本
坑
- 框架已经过时。README 里官方原话:“像深度学习里的其他东西一样,这个仓库很快就老了。”很多付费 SaaS 的音频质量已经超过它。官方建议,如果追求高音质开源方案,可以去看 Chatterbox 这类更新项目。
- 有硬件门槛。想跑实时推理需要 NVIDIA GPU,纯 CPU 环境虽然能跑但速度会明显受限。
- 音频质量停留在 2019 年水平。这是项目创建时间决定的,和 2025 年的语音克隆 SOTA 有差距。
- 依赖工具链。ffmpeg 和 uv 都是硬依赖,缺少任何一个都跑不起来。
适合你吗
适合:想研究语音克隆技术原理的人,需要一套开源参考实现来对照论文的开发者,以及愿意折腾环境、接受 2019 年音频质量的技术爱好者。
不适合:想要开箱即用、追求最高音质的人。这类需求官方明确建议转向付费 SaaS 产品或者更新的开源项目。初次接触 TTS 的小白也会遇到门槛——虽然 uv 简化了环境配置,但理解三个阶段的原理还需要一定的深度学习基础。
项目虽然“老”,但好处是,把三篇论文串成了一个可运行的整体。即使不直接用它做产品,拆开看每个模块的代码结构也是学习材料。另外,仓库协议标注为 NOASSERTION,如果要商用得注意确认授权范围。
常见问题
Real-Time-Voice-Cloning 是什么工具?
Real-Time-Voice-Cloning(又称 SV2TTS)是一个 2019 年发布的开源语音克隆项目,在 GitHub 上有超过 6 万 star。它能用短短几秒(官方称 5 秒内)的音频样本来提取声音特征,然后结合任意文本生成对应的语音,实现用 A 的声音来说 B 的内容。
Real-Time-Voice-Cloning 怎么安装?
安装需要先准备好 ffmpeg 和 uv 工具。Windows 和 Linux 系统可以通过命令行安装 uv(比如 Windows 用 powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex")。之后运行 uv run 命令会自动创建虚拟环境并安装项目依赖。
Real-Time-Voice-Cloning 是免费的吗?
是的,这是一个完全开源的项目,可以免费使用。但需要注意,它的代码协议标注为 NOASSERTION,这意味着如果你计划商用,需要自行确认和遵守相关的授权范围。
Real-Time-Voice-Cloning 和 OpenVoice 比哪个好?
Real-Time-Voice-Cloning 是 2019 年的经典参考实现,但官方承认其框架已过时,音频质量停留在当时水平。OpenVoice 是更新的开源实时语音克隆工具。如果追求更高音质,官方建议关注像 Chatterbox 这类更新的开源项目或付费 SaaS。
Real-Time-Voice-Cloning 对电脑配置要求高吗?
有硬件门槛。如果想实现项目名称中的“实时”推理,需要 NVIDIA GPU 支持。纯 CPU 环境也能运行(用 --extra cpu 参数),但生成速度会明显变慢。