Sherpa-onnx:多功能语音处理工具包
分类:工具实测 浏览量:4
摘要:
sherpa-onnx 是一个本地离线的多功能语音处理工具箱,集成了语音识别、语音合成、说话人分离、音频打标等十几种功能。它能帮助电商开发团队在离线环境下处理客服录音、会议纪要等敏感音频数据,满足隐私合规需求,并支持在PC、移动App、嵌入式设备等多种平台上部署,实现跨端语音交互。该工具尤其适合需要本地离线推理、有跨平台部署需求,且具备编译调试能力的语音交互产品开发团队使用。
开头
sherpa-onnx是一个本地离线的语音处理工具箱,把语音识别、语音合成、说话人分离、语音活动检测等十几种功能打包进一套跨平台SDK。开发者接入一次,就能在Windows、Linux、Android、iOS、HarmonyOS甚至RISC-V板子上运行,数据不用传到外网。
适合谁
嵌入式开发者。仓库支持RK NPU、Ascend NPU、Intel NPU(OpenVINO)这些NPU加速,也给Raspberry Pi、RV1126这类低算力板子准备了预编译方案。做语音交互硬件时,不用从头写推理逻辑。
多语言应用团队。官方说覆盖12种编程语言,像C++、Python、JavaScript、Java、C#、Kotlin、Swift、Go、Dart、Rust,还有Flutter和Tauri框架的预构建demo。同一个语音模型能用到PC客户端、移动App或Web前端,省得给每个平台重写一遍。
对离线数据敏感的技术团队。客服录音、会议纪要这类音频,出于合规或隐私考虑不能上传到云端API。sherpa-onnx全程在本地推理,正好满足这个需求。
能解决什么问题
离线语音识别。支持流式和非流式两种模式,没网的环境里也能转文字。README列出的功能矩阵显示,ASR、TTS、说话人识别、说话人验证、语种识别、音频打标、关键词唤醒这些都已经实现了。
多说话人场景分离。会议录音里有好几个人说话,用speaker diarization区分谁在什么时候开口;需要单独提取某个人声做转写,source separation模块能拆分音轨,比如用spleeter或UVR的模型分离伴奏和人声。
边缘设备跑语音。官方支持矩阵显示,x64、x86、arm64、arm32、riscv64架构都能跑,Android、HarmonyOS、Raspberry Pi也都覆盖了,并且明确支持5类NPU加速——Rockchip RKNN、Qualcomm QNN、Ascend、Axera、Intel OpenVINO。模型可以直接部署到终端设备,不限于服务器。
怎么开始用
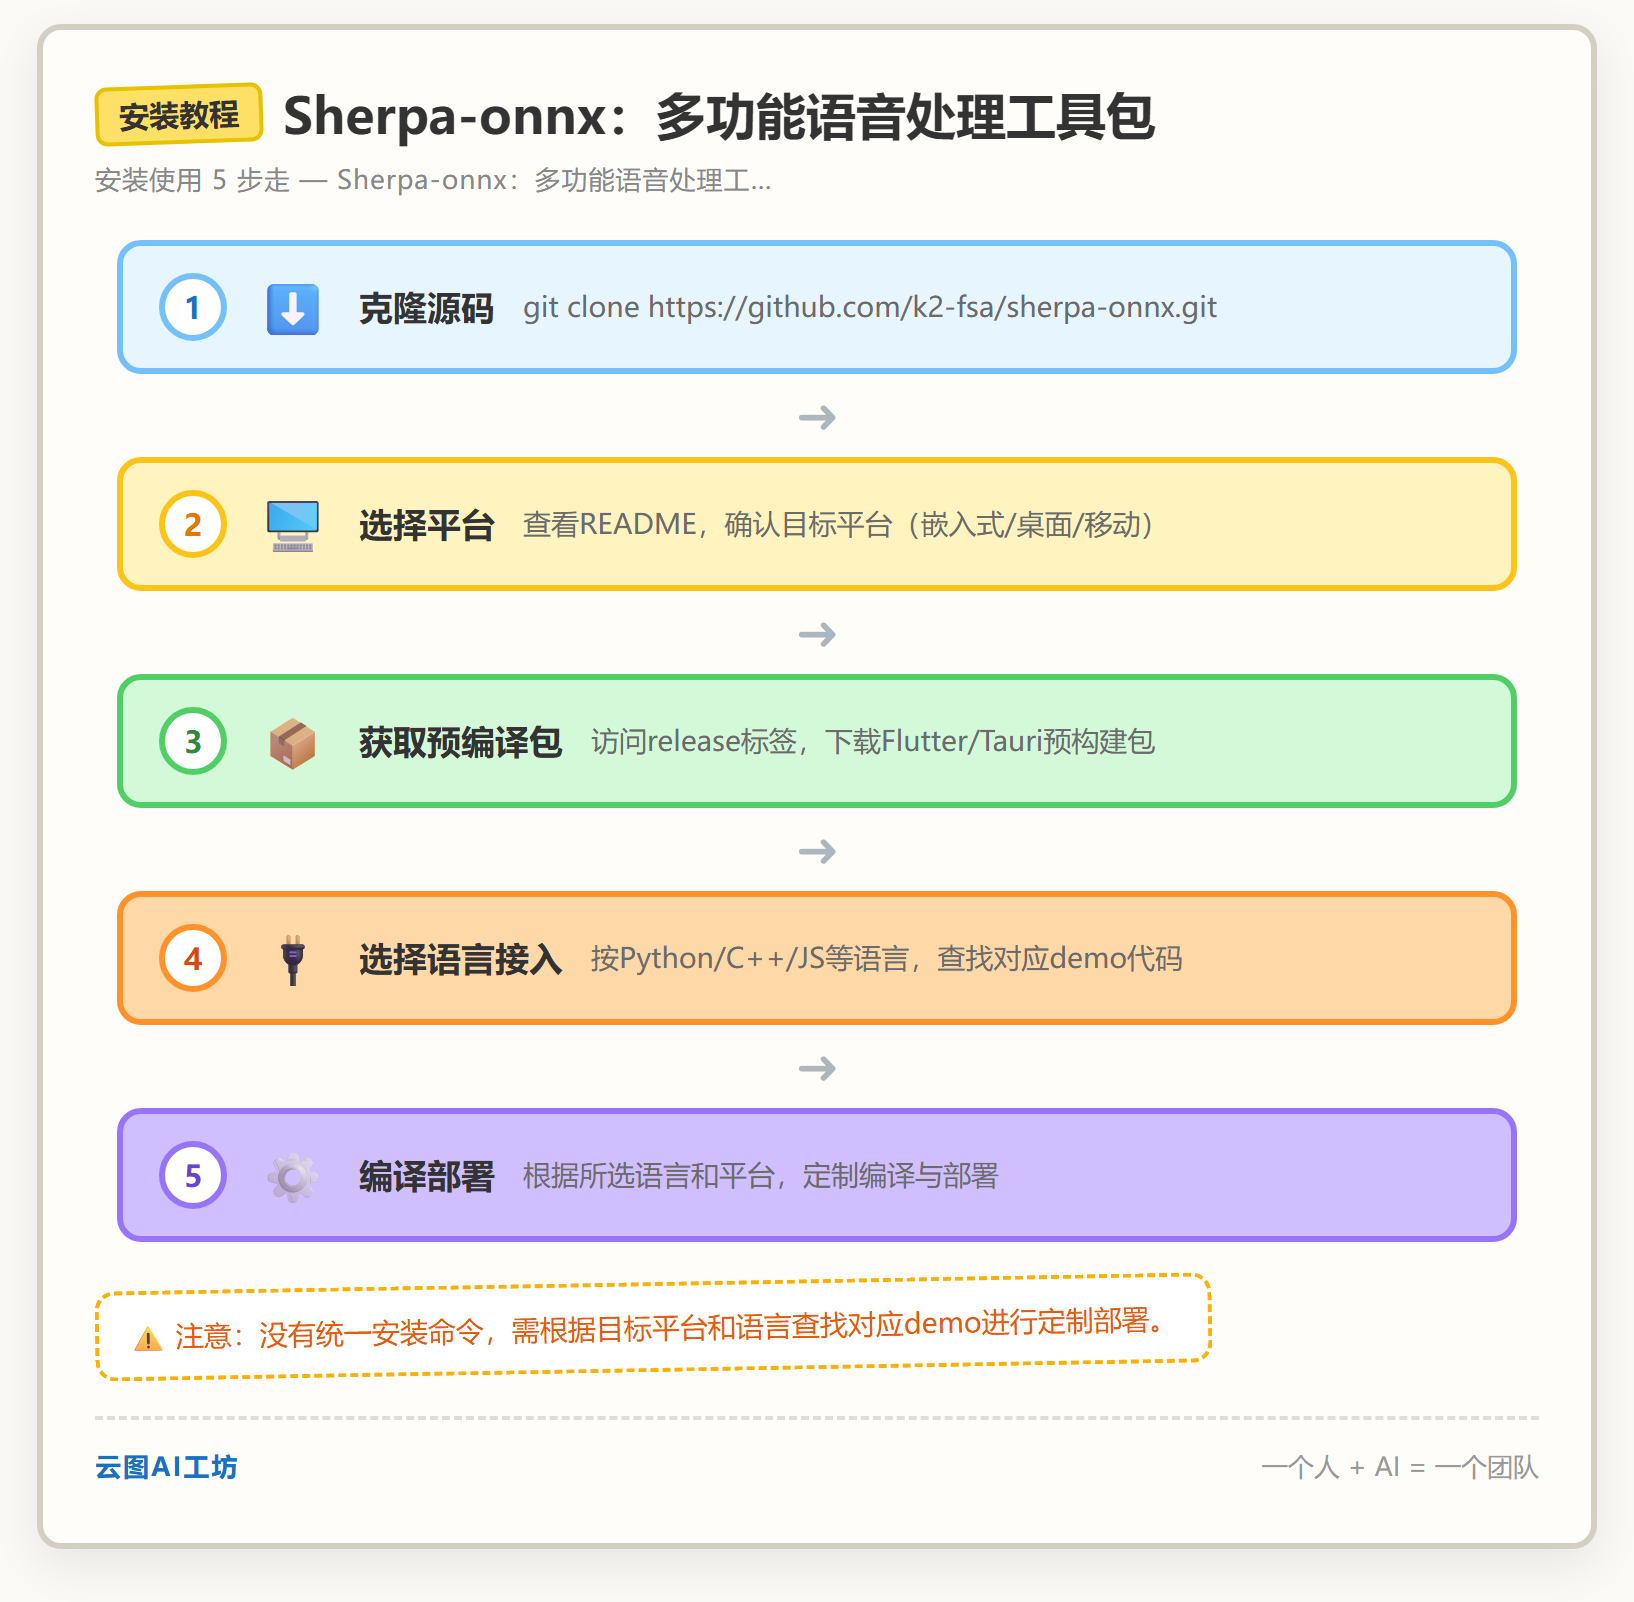
这是个开源项目(Apache-2.0协议),安装需要克隆源码自己编译。README说明,仓库支持通过Python包直接接入,也支持C++/C/JavaScript这些语言调用。针对嵌入式目标,官方在Flutter和Tauri两个框架下提供了预构建的release可以下载:
# 克隆项目
git clone https://github.com/k2-fsa/sherpa-onnx.git

# 查看各平台预编译demo(Flutter/Tauri)
# 对应release标签:
# https://github.com/k2-fsa/sherpa-onnx/releases/tag/flutter
# https://github.com/k2-fsa/sherpa-onnx/releases/tag/tauri

# 社区交流
https://discord.gg/fJdxzg2VbG
具体到每种语言的接入示例,README给的是功能清单和平台矩阵,没有统一的单行安装命令——它的部署路径偏定制,需要根据目标平台和所选语言去找对应的demo代码。
优点和坑
优点
1. 覆盖范围广。一个仓库同时搞定ASR、TTS、VAD、说话人分离、音频打标、关键词唤醒这些,单个项目解决多种音频处理需求,后续维护也集中。
2. 平台支持多。从服务器x86_64到RISC-V,再到Android/iOS/HarmonyOS,还有5款NPU加速,边缘侧和移动端都能用。
3. 不用联网。数据全程在本地处理,对隐私合规和离线场景是直接优势。
坑
1. 上手有门槛。项目面向开发者,需要自己编译、对接模型文件,适合动手能力强的人。非技术背景的人想直接用,第一步可能就卡住。
2. 模型得自己挑。README列出的是功能集合,没告诉你“哪个模型最好”——具体效果看你选的ASR/TTS模型、样本率和语言,得自己对比测试。
3. 嵌入式平台要交叉编译。虽然官方说支持RK NPU、RISC-V、RV1126,但这类目标的部署不是pip install就能搞定,得按目标芯片的SDK走独立流程,需要看对应文档。
4. 文档比较分散。核心矩阵和NPU支持信息分布在主README和各个专题文档里(比如OpenVINO单独一个.md),第一次用要花时间把信息拼起来——官方提供了Discord社区,遇到问题可以先过去搜搜看。
适合你吗
适合:正在做语音交互类产品的开发团队,特别是需要本地离线推理、要跨平台部署(PC/移动/嵌入式)、有编译和调试能力的技术人员;对多说话人识别、关键词唤醒这类细分功能有明确需求的工程师用起来会比较顺手。
不太适合:不想碰代码、想要开箱即用成品软件的人;或者项目只跑在x86服务器上、对端侧没要求的场景,这个工具箱的优势体现不出来,直接用云端API更省事。另外,如果团队没有编译环境或者不熟悉模型调优,建议先在PC平台跑通demo再决定。
常见问题
sherpa-onnx支持流式语音识别或语音合成吗?
支持。语音识别功能明确支持流式和非流式两种模式,没网也能用。语音合成是否支持流式,正文没提具体模式,但这个功能已经实现,详情建议查官方文档或问社区。
sherpa-onnx的语音识别准确率怎么样?
正文没给具体的准确率数据。sherpa-onnx本身是个工具箱,识别效果取决于你选的ASR模型、样本率和语言,得自己对比测试。官方README列出了功能,但没给出“哪个模型最好”的现成答案。
如何在手机(如安卓)上部署sherpa-onnx?
可以部署。sherpa-onnx支持Android、iOS、HarmonyOS这些移动平台。针对嵌入式或移动端目标,官方在Flutter和Tauri框架下提供了预构建的release可以下载。具体部署需要根据目标平台和所选语言(比如Java、Kotlin)去查对应的demo代码来对接,不是一条安装命令就能解决。
sherpa-onnx的模型文件从哪里获取?
正文提到,用sherpa-onnx需要开发者自己对接模型文件。README列出的是功能集合,没有直接提供或推荐具体的模型文件下载来源。你得根据自己的需求(比如ASR、TTS、说话人分离)去找合适的onnx格式模型文件,然后集成测试。
sherpa-onnx是免费的吗?支持哪些硬件加速?
sherpa-onnx是开源项目,采用Apache-2.0协议,免费使用。它支持多种NPU硬件加速,包括Rockchip RKNN、Qualcomm QNN、华为Ascend、Axera、以及Intel的OpenVINO,同时也能在x86、ARM、RISC-V这些通用CPU架构上运行。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。