实时语音转文字怎么做?RealtimeSTT 库打包语音识别链路
分类:工具实测 浏览量:198
摘要:
RealtimeSTT 是一个为开发者设计的开源库,它将实时语音识别链路打包,能实时监听麦克风,检测人声后立即将语音转为文字,并支持唤醒词。它主要帮助电商或工具开发者解决为产品添加实时语音输入能力的难题,例如快速构建语音助手、自动化会议记录、直播字幕生成或硬件设备语音控制等功能,省去了自行处理语音活动检测和流式识别的复杂工作。该库适合需要为项目集成实时语音转文字功能的开发者,特别是那些从事语音助手、速记工具或直播字幕应用开发的技术人员。
RealtimeSTT 这个库,简单说就是给程序加"耳朵"用的——它能实时听麦克风、检测到人声后立刻转成文字,还支持唤醒词。对做工具类产品、自动化脚本的开发者来说,这是省掉一大截语音处理功夫的现成零件。
适合谁
做语音助手的开发者:不管是桌面助手、浏览器里的语音输入,还是给硬件设备加语音控制,RealtimeSTT 把"听到声音→识别成文字"这条链路打包好了,几行代码就能接进自己的项目。
搞自动化记录的工具作者:比如会议纪要工具、口述速记软件、直播字幕生成,这类需要"边听边出字"的场景,它内置的语音活动检测(VAD)能自动判断人什么时候开始说话、什么时候停顿,不用自己写静音检测逻辑。
折腾本地部署的技术爱好者:项目默认走 faster-whisper 引擎,支持 CUDA 用 GPU 加速;如果你只有 CPU,官方文档也给了专门的优化方案(sherpa-onnx 模型搭配),适合在意隐私、不想把音频传云端的人。
能解决什么问题
实时出字,不用等整段说完:默认引擎 faster-whisper 支持流式识别,说话过程中就能不断吐出文字,不是等你说完才一次性给结果。对做字幕、速记这类应用很关键。
自动检测说话起止:内置语音活动检测,能判断人开始说话和结束说话。官方给的麦克风示例就是"等你说完,自动停止并打印结果",不用手动控制录音开关。
支持唤醒词和外部音频流:除了麦克风,也接受文件、网络流等外部音频输入(16kHz 单声道 PCM 格式),还能设置唤醒词——适合做"喊名字才响应"的交互。
怎么开始用
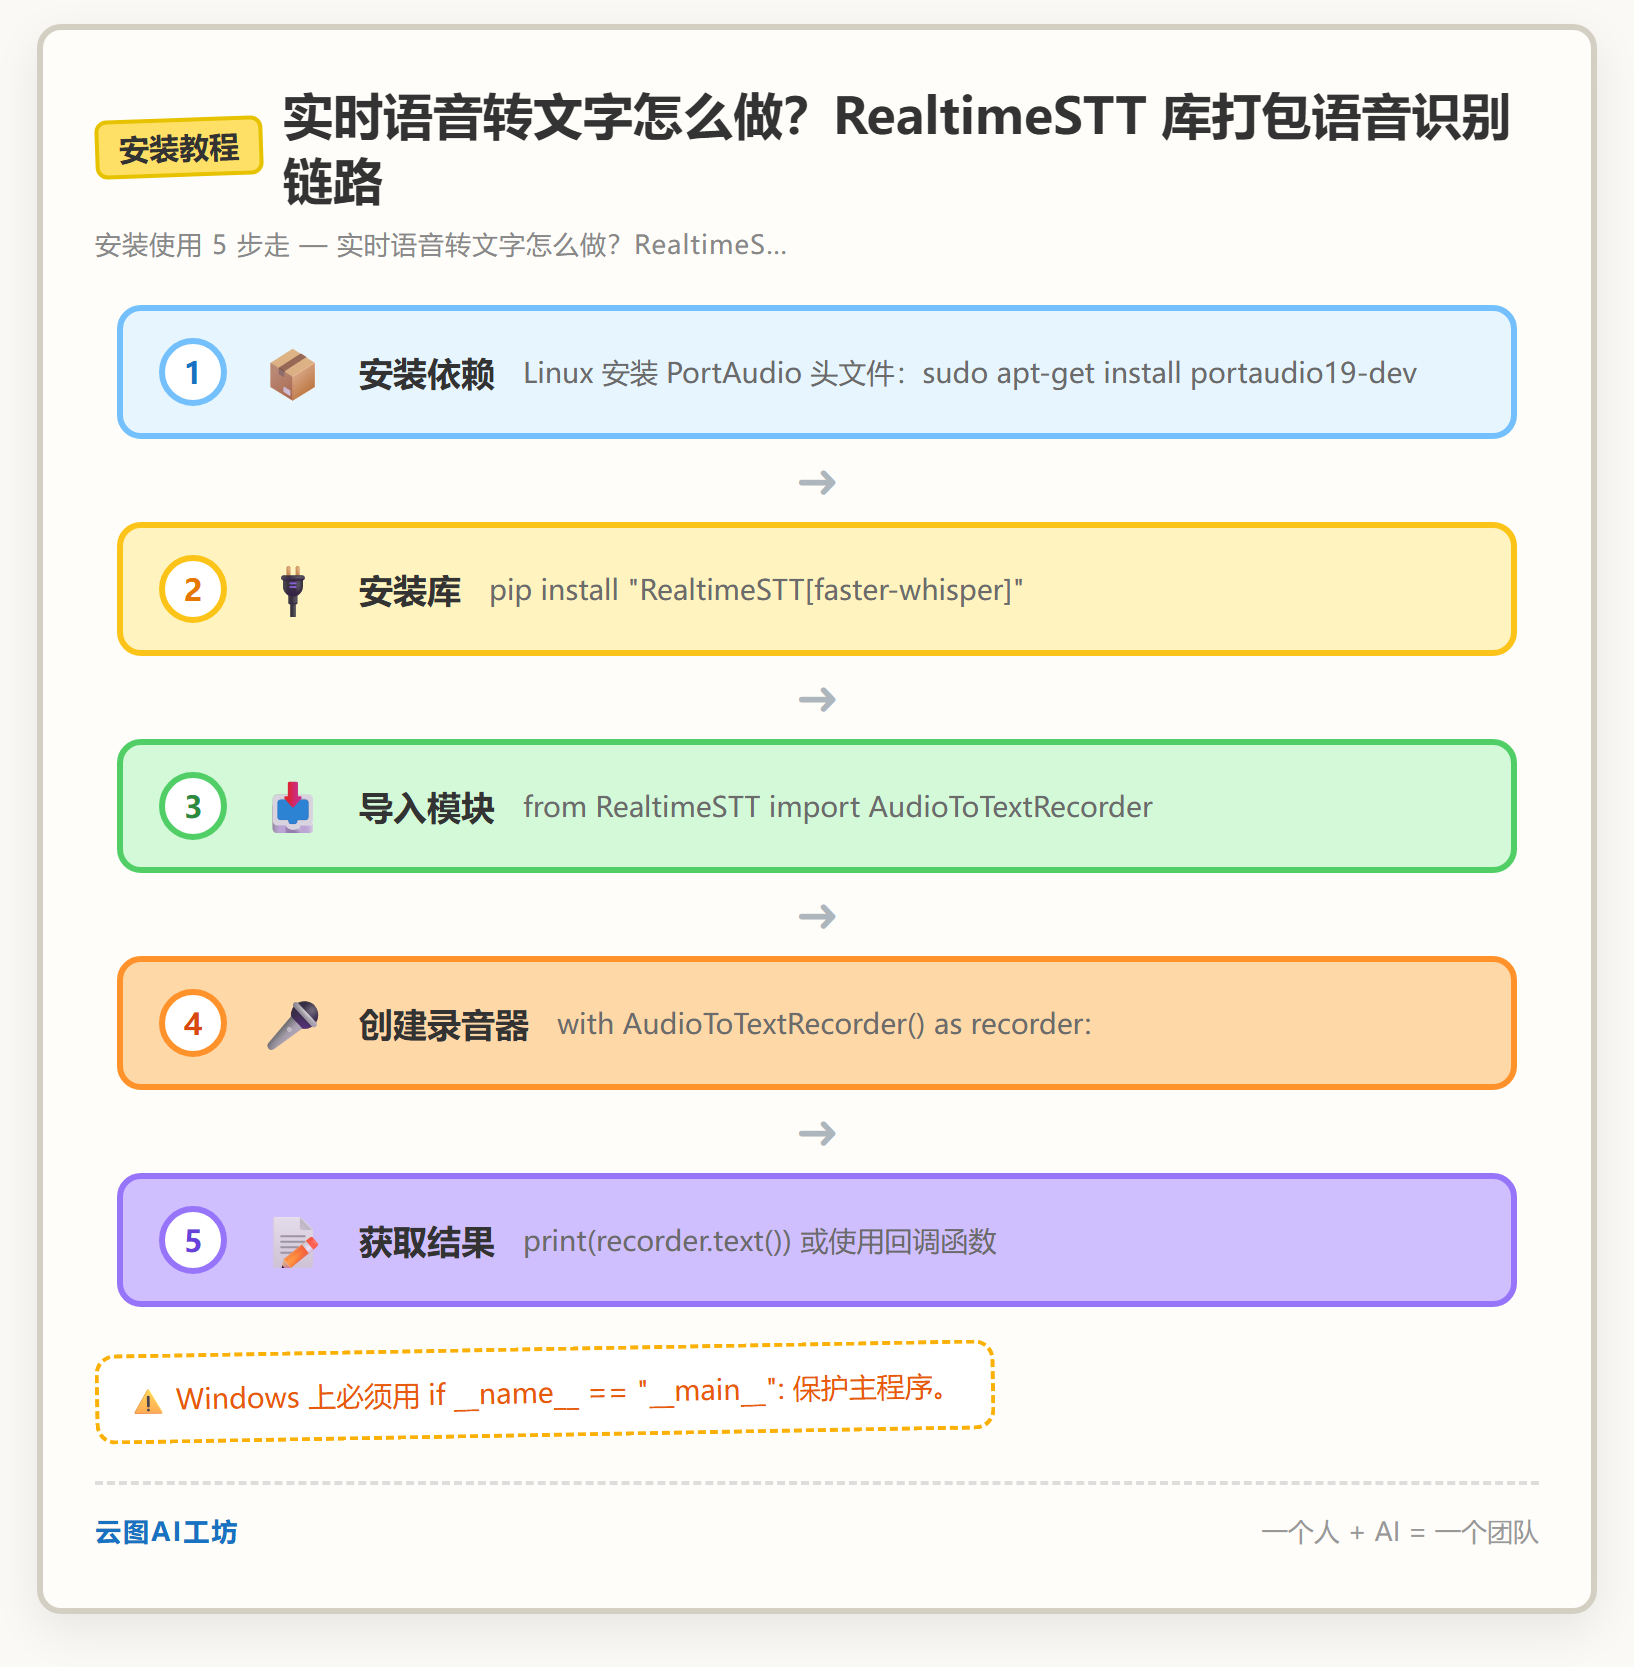
安装基础版(faster-whisper 引擎):
pip install "RealtimeSTT[faster-whisper]"
Linux 需要先装 PortAudio 头文件:
sudo apt-get update
sudo apt-get install python3-dev portaudio19-dev
macOS 用 Homebrew:
brew install portaudio
最简单的麦克风示例——等你说完,打印结果:
from RealtimeSTT import AudioToTextRecorder

if __name__ == "__main__":
    with AudioToTextRecorder() as recorder:
        print("Speak now")
        print(recorder.text())
注意 Windows 上跑一定要加 if __name__ == "__main__": 保护,因为库内部用了多进程。
连续听写、边听边处理,用回调函数:
from RealtimeSTT import AudioToTextRecorder

def process_text(text):
    print(text)

if __name__ == "__main__":
    recorder = AudioToTextRecorder()
    while True:
        recorder.text(process_text)
优点和坑
优点:
- 上手快:核心 API 就一个
AudioToTextRecorder类,麦克风示例不到十行代码能跑通。 - 引擎可换:默认 faster-whisper,也可以装 sherpa-onnx、kroko_onnx 等其他引擎,按需选择。
- 项目活跃:GitHub 上 10200 star、862 fork,MIT 协议随便用,最近一次更新是 2026 年 10 月,维护状态健康。
坑(真实存在的):
- Python 版本有限制:官方 CI 只覆盖 Python 3.11 和 3.12,3.13 及更新版本不是发布目标,装之前先确认环境。
- Linux 依赖前置:不装 PortAudio 头文件直接 pip install 会报错,得先跑
sudo apt-get install python3-dev portaudio19-dev。 - CPU 性能要调优:默认 faster-whisper 在 CPU 上做流式识别,反复重转录增长的音频缓冲会越来越慢。官方推荐 CPU 生产环境换 sherpa-onnx 的专用模型组合(Nemotron 处理增量、Parakeet 出最终结果),但这需要额外安装和下载模型,不是开箱即用。
- 多进程注意:库用 multiprocessing 做模型推理,Windows 下不加
if __name__ == "__main__":会直接报错。
适合你吗
适合:想快速给项目加语音转文字功能、能接受 Python 3.11/3.12 环境、愿意花半小时处理系统依赖的开发者。尤其是做语音助手、速记工具、直播字幕这类需要实时出字的应用,它把 VAD 和流式识别都封装好了。
不适合:完全不想碰命令行、只想装个现成软件用的普通用户——这是个开发库,不是成品软件;或者你的生产环境是 CPU 且对延迟要求极高,那需要额外研究 sherpa-onnx 那套优化方案,不是装上就能跑满性能。
---
常见问题
RealtimeSTT 库是免费的吗?
是的,完全免费。它是一个开源项目,采用 MIT 协议,你可以在 GitHub 上找到它(拥有超过 10200 个星标),可以随意用于个人或商业项目。
RealtimeSTT 怎么安装?需要什么环境?
安装基础版用命令:pip install "RealtimeSTT[faster-whisper]"。但要注意,它官方主要支持 Python 3.11 和 3.12 版本,Python 3.13 及以上不是目标版本。Linux 用户需先运行 sudo apt-get install python3-dev portaudio19-dev 安装依赖。
RealtimeSTT 的语音识别准确率怎么样?
正文未直接提及具体准确率数字。它默认使用 faster-whisper 引擎进行流式识别,支持 GPU 加速以提升性能。如果对 CPU 环境下的性能不满意,官方推荐换用 sherpa-onnx 的专用模型组合进行优化。
RealtimeSTT 能离线使用吗?
可以,非常适合离线使用。默认的 faster-whisper 引擎以及可选的 sherpa-onnx 模型都支持本地部署,无需将音频数据上传到云端,适合注重隐私的用户。
RealtimeSTT 和别的语音转文字工具比有什么优势?
主要优势是封装了完整的实时语音识别链路,上手快。它内置语音活动检测(VAD)自动判断说话起止,支持流式识别实现“边听边出字”,并且核心 API 只有一个 AudioToTextRecorder 类,几行代码就能接入麦克风实时转写。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。