Open-LLM-VTuber:开源虚拟主播交互系统
分类:工具实测 浏览量:96
摘要:
Open-LLM-VTuber 是一个整合了大语言模型、语音识别、语音合成和 Live2D 虚拟形象的开源项目,所有功能均可本地离线运行。它能帮助用户搭建一个本地语音助手,实现实时语音对话并支持打断,还能通过视觉感知功能“看”屏幕内容,作为桌面AI助手原型。该项目主要适合AI应用开发者研究语音交互链路、本地部署爱好者保障数据隐私,以及Live2D模型创作者为自己的模型赋予对话能力。
Open-LLM-VTuber 是个能跟你实时语音聊天的开源项目,它把大语言模型、语音识别、语音合成和 Live2D 虚拟形象整合在一起,全部本地运行。对开发者来说,这意味着你可以完全掌控数据流向,搭建一个属于自己的、能看见你屏幕内容的 AI 桌面伙伴。
适合谁
- AI 应用开发者:想研究语音交互链路(ASR → LLM → TTS)如何串联,或者想给现有 LLM 应用加一个语音入口和虚拟形象。
- 本地部署爱好者:追求数据隐私,希望所有推理都在自己的电脑上完成,不依赖云端 API。
- Live2D 模型创作者:想给自己做的模型找一个能对话的“身体”,项目支持自定义角色外观和性格。
能解决什么问题
1. 搭建本地语音助手:项目整合了语音识别和语音合成,你可以对着麦克风说话,让 LLM 回答后再用语音播报出来,整个过程支持打断(voice interruption),体验接近实时对话。
2. 给 LLM 加视觉能力:项目支持“视觉感知”(visual perception),意味着你可以让它“看”你的屏幕内容,并基于此进行对话,适合做桌面级 AI 助手原型。
3. 跨平台桌面宠物:支持 Windows、macOS、Linux,还特别提供了透明背景桌面宠物模式,让虚拟形象悬浮在屏幕任意位置,作为桌面陪伴。
怎么开始用
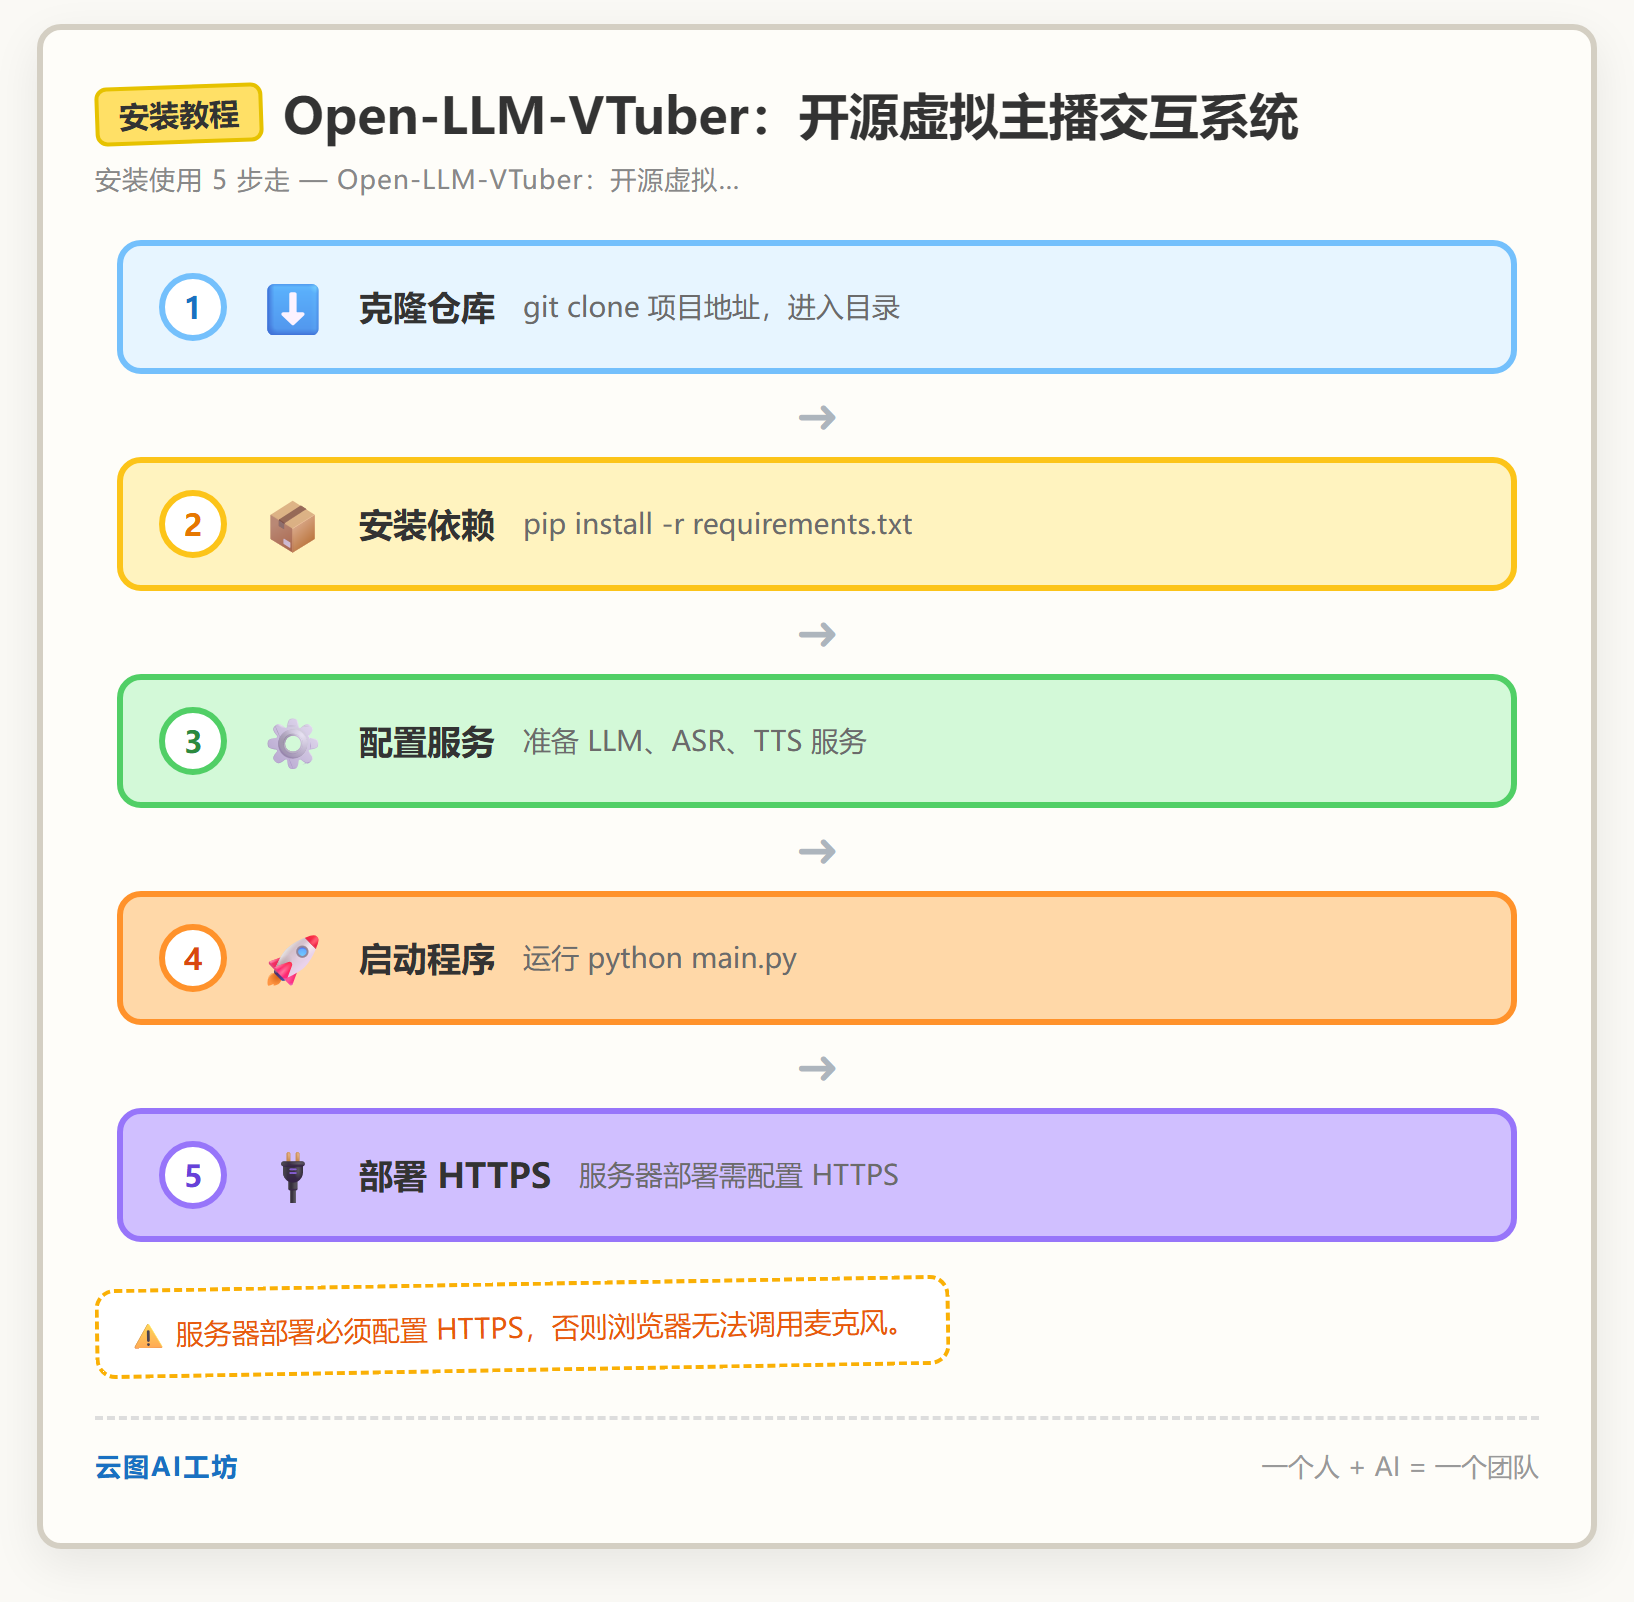
项目提供 Web 版和桌面客户端两种使用方式,也支持 Docker 部署。以下是根据官方文档整理的快速启动思路:
# 1. 克隆仓库
git clone https://github.com/Open-LLM-VTuber/Open-LLM-VTuber.git
cd Open-LLM-VTuber

# 2. 安装依赖(以 Python 环境为例)
pip install -r requirements.txt

# 3. 配置后端服务
# 你需要准备 LLM 推理服务(如 Ollama)、语音识别(ASR)和语音合成(TTS)服务
# 具体配置项请参考官方文档:https://open-llm-vtuber.github.io/docs/quick-start

# 4. 启动主程序
python main.py
> 注意:如果你想把服务跑在服务器上,然后用手机访问,必须配置 HTTPS。因为浏览器只有在安全上下文(HTTPS 或 localhost)下才会允许网页调用麦克风。
优点和坑
优点:
- 全离线运行:所有功能都能在本地跑,不依赖外部 API,数据隐私有保障。
- 生态丰富:项目集成了多种 LLM 推理、TTS 和语音识别方案,选择灵活。
- 社区活跃:GitHub 上 14.3k star,有 QQ 群和 Discord 社区,遇到问题能找到人讨论。
坑(真实存在的限制):
1. 项目处于早期阶段:README 明确标注“active development”,功能变动可能较快,长期记忆功能暂时移除(官方说快回来了)。
2. 部署有门槛:需要自己配置 LLM、ASR、TTS 三个后端服务,对新手来说不是开箱即用,需要一定的技术背景。
3. 远程访问必须配 HTTPS:如果你不想只在 localhost 玩,想用手机访问,就得自己搭反向代理配证书,这一步会卡住不少人。
4. v2.0 重写中:官方正在完全重写代码库(v2.0),目前处于早期讨论阶段,v1 只修 bug,不再接受新功能请求。你现在学的 v1 架构可能很快会被 v2 取代。
适合你吗
适合你,如果:你是开发者或技术爱好者,想研究或搭建一个本地语音交互 AI 形象,能接受自己折腾配置三个后端服务,并且不介意项目处于快速迭代期。
不适合你,如果:你希望开箱即用、点开就能聊;或者你需要稳定的生产环境;或者你对命令行和配置文件感到头疼。这个项目目前的定位是“能跑起来的框架”,不是“装好的成品”。
常见问题
Open-LLM-VTuber 是免费开源的虚拟主播软件吗?
是的,Open-LLM-VTuber 是一个完全免费且开源的项目,代码托管在 GitHub 上。它支持在本地电脑上离线运行,整合了语音识别、大语言模型和语音合成,无需依赖付费的云端 API,但需要用户自己配置相关的后端服务。
Open-LLM-VTuber 怎么进行本地部署?
部署 Open-LLM-VTuber 需要一定技术基础。主要步骤包括:克隆 GitHub 仓库,用 pip install -r requirements.txt 安装 Python 依赖,然后自行配置 LLM(如 Ollama)、语音识别(ASR)和语音合成(TTS)三个后端服务。具体配置需参考官方文档。
Open-LLM-VTuber 支持哪些操作系统?
Open-LLM-VTuber 支持跨平台使用,包括 Windows、macOS 和 Linux 系统。它还特别提供了透明背景桌面宠物模式,可以让虚拟形象悬浮在屏幕任意位置,作为桌面陪伴。
用手机访问 Open-LLM-VTuber 服务需要注意什么?
如果你想把服务跑在服务器上,然后用手机浏览器访问,必须配置 HTTPS。因为浏览器只有在安全上下文(HTTPS 或 localhost)下才会允许网页调用麦克风进行语音对话,这一步需要自己搭建反向代理和配置证书。
Open-LLM-VTuber 和同类工具比有什么优缺点?
优点是全离线运行,数据隐私好;生态丰富,集成多种 LLM 和语音方案;社区活跃(GitHub 14.3k star)。缺点是部署有门槛,需自配三个后端;项目处于早期快速迭代期(v2.0正在重写),功能可能变动,且远程访问必须配 HTTPS。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。