卖家怎么做多语言商品配音?OmniVoice 600+语言克隆
分类:工具实测 浏览量:9
摘要:
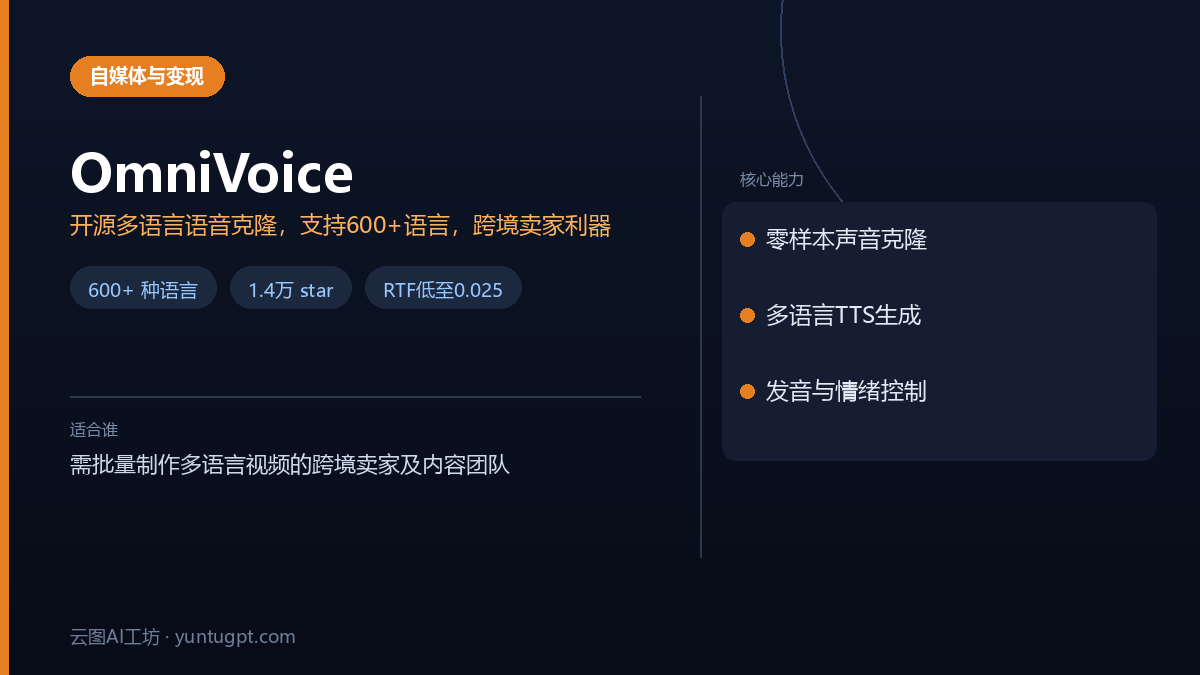
OmniVoice是一个开源的多语言语音克隆工具,它能够根据用户提供的一段声音样本,克隆出该声音并用其说出600多种语言。这款工具旨在帮助跨境电商卖家、短视频带货团队及海外社媒运营者解决多语言内容制作的痛点,例如无需为每种语言单独聘请配音,即可批量生成多语言的商品介绍视频、客服语音和社媒口播,同时保持品牌音色的一致性。它适合具备基本命令行操作能力、愿意自行配置环境并需要批量产出多语言视频内容的用户。
多语言语音克隆怎么做:OmniVoice 支持 600+ 语言的声音复刻
做跨境电商的朋友应该都有这个痛点:店铺要面向好几个国家的客户,视频和直播却只能用一种语言配音。请翻译配音贵,自己录又不专业。今天聊的 OmniVoice 就是干这个的——一个开源的多语言语音克隆工具,你给它一段声音样本,它就能用这个声音说 600 多种语言。对要做多语言商品介绍、客服语音、社媒视频的卖家来说,这是个值得关注的方向。
适合谁
做跨境店铺的卖家:店铺面向多个国家,需要把商品介绍视频、直播预告、客服语音做成多语言版本。用 OmniVoice 克隆自己的声音后,一段中文介绍就能自动转成英语、西班牙语、阿拉伯语等版本。
做短视频带货的内容团队:需要批量产出多语言口播视频,又不想每次都重新录音。用声音克隆可以保持同一个音色,批量生成不同语言的视频配音。
做海外社媒运营的个体户:TikTok、Instagram 上发视频,配上当地语言的口播比字幕效果好得多。OmniVoice 支持 600+ 语言,覆盖面远超主流商业 TTS 服务。
能解决什么问题
多语言商品介绍批量生成:录一段中文商品介绍,用 OmniVoice 克隆声音后,可以生成几十种语言版本,不用逐个语言找人配音。官方数据是支持 600+ 语言,是目前零样本 TTS 模型里覆盖最广的。
声音统一性问题:如果你有多个账号或店铺,可以用同一个克隆声音生成所有视频配音,保持品牌声音一致。支持通过性别、年龄、音调、方言口音等属性来调整声音风格。
特殊发音和情绪控制:商品名、品牌名经常有特殊读法,OmniVoice 支持用拼音或音素纠正发音,还能插入笑声等非语言符号。比如 [laughter] 这样的标记可以直接写进文本。
怎么开始用
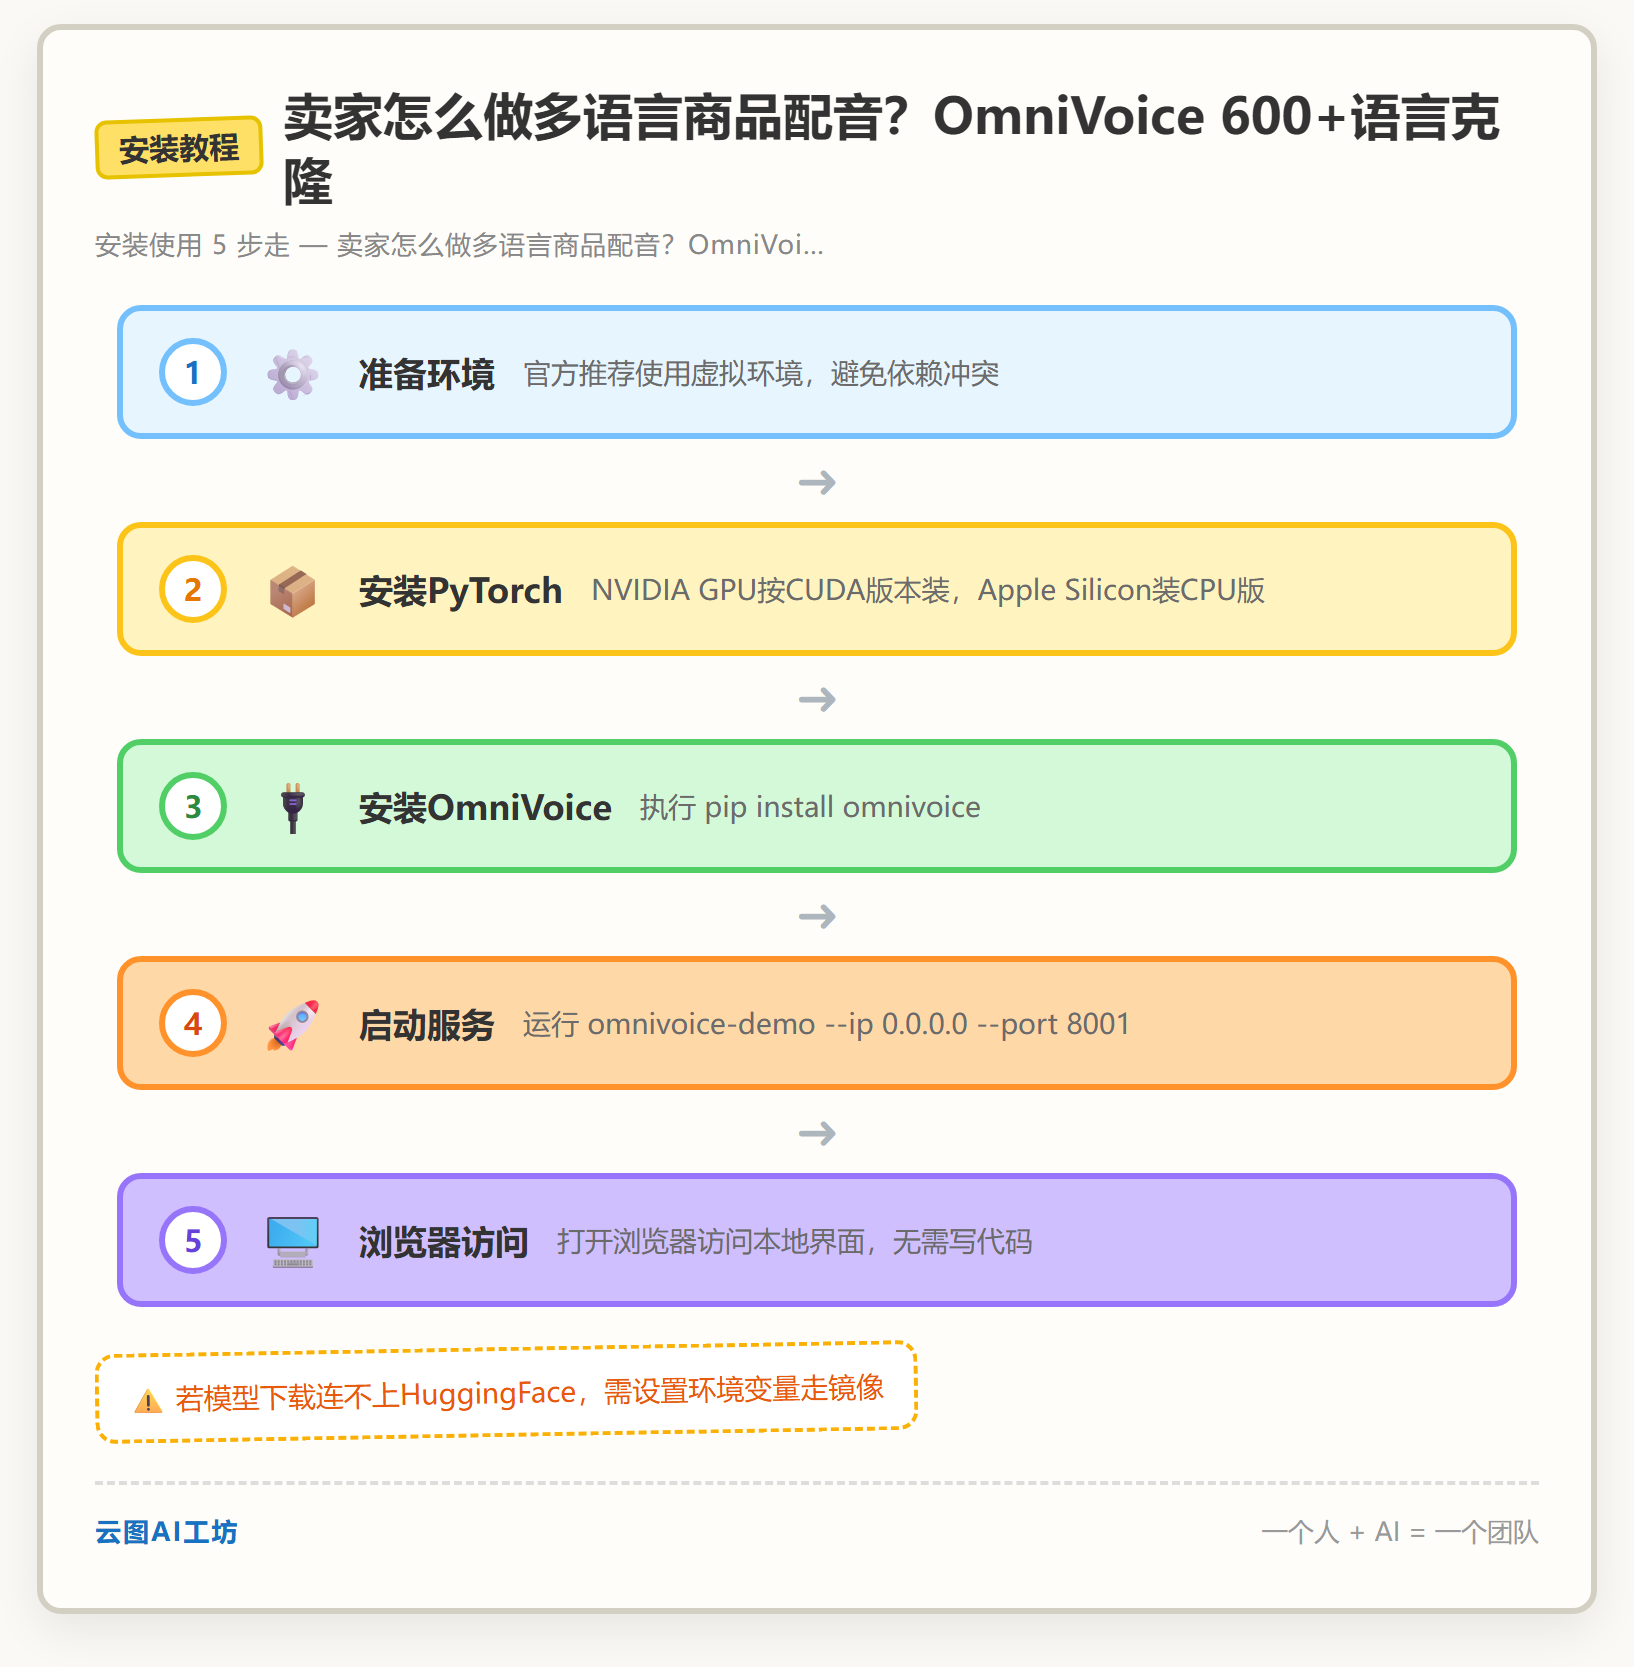
先装 PyTorch,再装 OmniVoice。官方推荐用虚拟环境避免依赖冲突。NVIDIA GPU 用户按自己的 CUDA 版本装,比如:
pip install torch==2.8.0+cu128 torchaudio==2.8.0+cu128 --extra-index-url https://download.pytorch.org/whl/cu128
Apple Silicon 用户直接装 CPU 版即可:
pip install torch==2.8.0 torchaudio==2.8.0
然后安装 OmniVoice:
pip install omnivoice
装完直接启动本地网页界面:
omnivoice-demo --ip 0.0.0.0 --port 8001
浏览器打开就能用,不用写代码。嫌麻烦也可以直接用 HuggingFace 上的在线 Space,或者用 Google Colab 跑官方笔记本。模型下载如果连不上 HuggingFace,设置一下环境变量走镜像就行。
优点和坑
优点:
- 语言覆盖极广,600+ 语言,做跨境基本够用
- 推理速度快,官方数据 RTF 最低 0.025,也就是比实时快 40 倍,批量生成不煎熬
- 支持声音克隆和声音设计两种模式,既能复制特定声音,也能按属性造新声音
坑:
- 部署有门槛:虽然提供了网页界面,但安装 PyTorch 和配置 GPU 环境对不熟悉命令行的卖家来说还是有点吃力。没有 NVIDIA GPU 的话,Apple Silicon 和 Intel Arc 也能跑,但速度会慢
- 模型文件大:预训练模型从 HuggingFace 下载,国内网络环境下可能需要配镜像,这一步容易卡住
- 克隆质量依赖样本:声音克隆效果跟提供的音频样本质量直接相关,背景噪音大、语速太快都会影响效果。官方没说最少需要多长的样本,但这类模型通常需要几秒到几十秒的清晰人声
- 没有商业授权说明:项目是 Apache-2.0 协议,但用克隆声音做商业视频是否合规、是否需要标注来源,建议自己确认清楚
适合你吗
适合:有基本命令行操作能力、愿意花半小时配置环境的跨境卖家;需要批量产出多语言视频内容的团队;对声音克隆技术感兴趣、想自己折腾的个体户。
不适合:完全不想碰命令行的纯操作型卖家——建议等第三方封装好的在线服务;对声音版权敏感、担心克隆声音被滥用的场景;需要实时语音交互(比如直播连麦)的情况,OmniVoice 定位是 TTS,不是实时语音转换。
一句话总结:OmniVoice 是目前开源 TTS 里语言覆盖最广的项目之一,1.4 万 star 说明社区认可度不低。但它是工具,不是服务——适合愿意动手的人,不适合想开箱即用的人。
---
常见问题
OmniVoice有手机版或者安卓版可以下载吗?
文章中没有提到OmniVoice有官方的手机版或安卓APP。它是一个开源的语音克隆工具,主要通过命令行在电脑上安装使用(需要Python环境),或者通过HuggingFace Space、Google Colab等在线平台运行。如果你看到‘手机版下载’,可能是非官方渠道,建议谨慎对待。
OmniVoice的官方下载地址和安装方法是什么?
OmniVoice是开源项目,没有传统意义上的‘官网下载’。安装方法是先通过pip命令安装PyTorch(例如:pip install torch==2.8.0+cu128),然后安装OmniVoice(pip install omnivoice)。安装后,可通过命令‘omnivoice-demo --ip 0.0.0.0 --port 8001’启动本地网页界面使用。模型文件从HuggingFace下载。
OmniVoice语音合成是免费的吗?
根据文章,OmniVoice是一个开源项目(Apache-2.0协议),这意味着工具本身可以免费使用和修改。但是,你需要自行准备计算资源(如GPU)来运行它。文中也提醒,用克隆声音做商业视频的合规性需要用户自行确认。
OmniVoice怎么安装,对电脑有什么要求?
安装需要先配置Python环境并安装PyTorch。有NVIDIA GPU的用户需根据CUDA版本安装对应的PyTorch(如pip install torch==2.8.0+cu128)。Apple Silicon用户可安装CPU版。然后执行‘pip install omnivoice’即可。主要门槛是需要命令行操作能力,并且模型文件较大,国内网络下载可能需配置镜像。
OmniVoice和同类语音克隆工具比有什么优势?
文章指出OmniVoice的核心优势是语言覆盖极广,支持600多种语言,远超主流商业TTS服务。它推理速度快(比实时快40倍),适合批量生成。同时支持声音克隆和按属性(性别、年龄等)设计新声音,功能比较全面。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。