DeepSpeech:Mozilla开源语音转文字引擎
分类:工具实测 浏览量:12
摘要:
DeepSpeech 是 Mozilla 开源的一款离线语音转文字引擎,基于 TensorFlow 实现,可在从树莓派 4 到 GPU 服务器的多种设备上本地运行。它能帮助电商开发者在无网络环境下实现实时语音转写,例如用于智能客服、离线语音控制等场景,并能通过本地化处理保护用户语音隐私、降低长期使用成本。该工具尤其适合注重数据隐私、需要在嵌入式或边缘设备中集成语音功能,且有较强技术能力进行部署和适配的技术团队。
DeepSpeech:Mozilla 开源离线语音转文字引擎
DeepSpeech 是 Mozilla 开源的一个语音转文字引擎,基于百度 Deep Speech 研究论文的思路,用 TensorFlow 实现,主打离线、嵌入式、实时运行——从树莓派 4 到高功率 GPU 服务器都能跑。对开发者来说,它提供了一条不依赖云服务的本地语音识别路径。
这个项目在 GitHub 上积累了 26771 个 star、4073 个 fork,最近更新是 2026-10-07,不过官方 README 里明确标注为 discontinued(已停止维护)。仓库地址:https://github.com/mozilla/DeepSpeech
适合谁
嵌入式 / 边缘设备开发者。官方描述里有句话是核心卖点:可以在树莓派 4 这种低功耗设备上实时运行。如果你在做智能音箱、离线语音控制、门禁语音交互这类产品,DeepSpeech 是小成本切入语音识别的方案之一。
注重数据隐私的应用开发者。语音转文字如果走云端 API,音频数据都要上传。DeepSpeech 完全本地推理,音频不出设备,对于处理敏感对话内容的工具来说这个属性很重要。
想自建离线语音服务的技术团队。配合预训练模型和微调能力,可以针对特定领域做定制。README 提到训练模型和 checkpoint 都可以在 GitHub 最新 release 里找到。
能解决什么问题
无网络环境下的实时语音转文字。比如车载、工控、野外作业等场景,DeepSpeech 直接跑在本地设备上,不依赖网络连接。官方说可以在树莓派 4 这一档的设备上实时运行。
降低每小时的语音转写成本。云服务按量计费,长时间录音转文字费用可观。DeepSpeech 一次部署,后续推理只花电费。对于需要批量处理语音的小团队,这个账算得过来。
语音功能嵌入现有应用的最后一公里。DeepSpeech 提供 Python 等语言的绑定,开发者可以把它作为一个模块集成到自己的应用里,而不是从零训练语音模型——毕竟训练需要数据积累和 GPU 资源,直接拿预训练模型起步省事很多。
怎么开始用
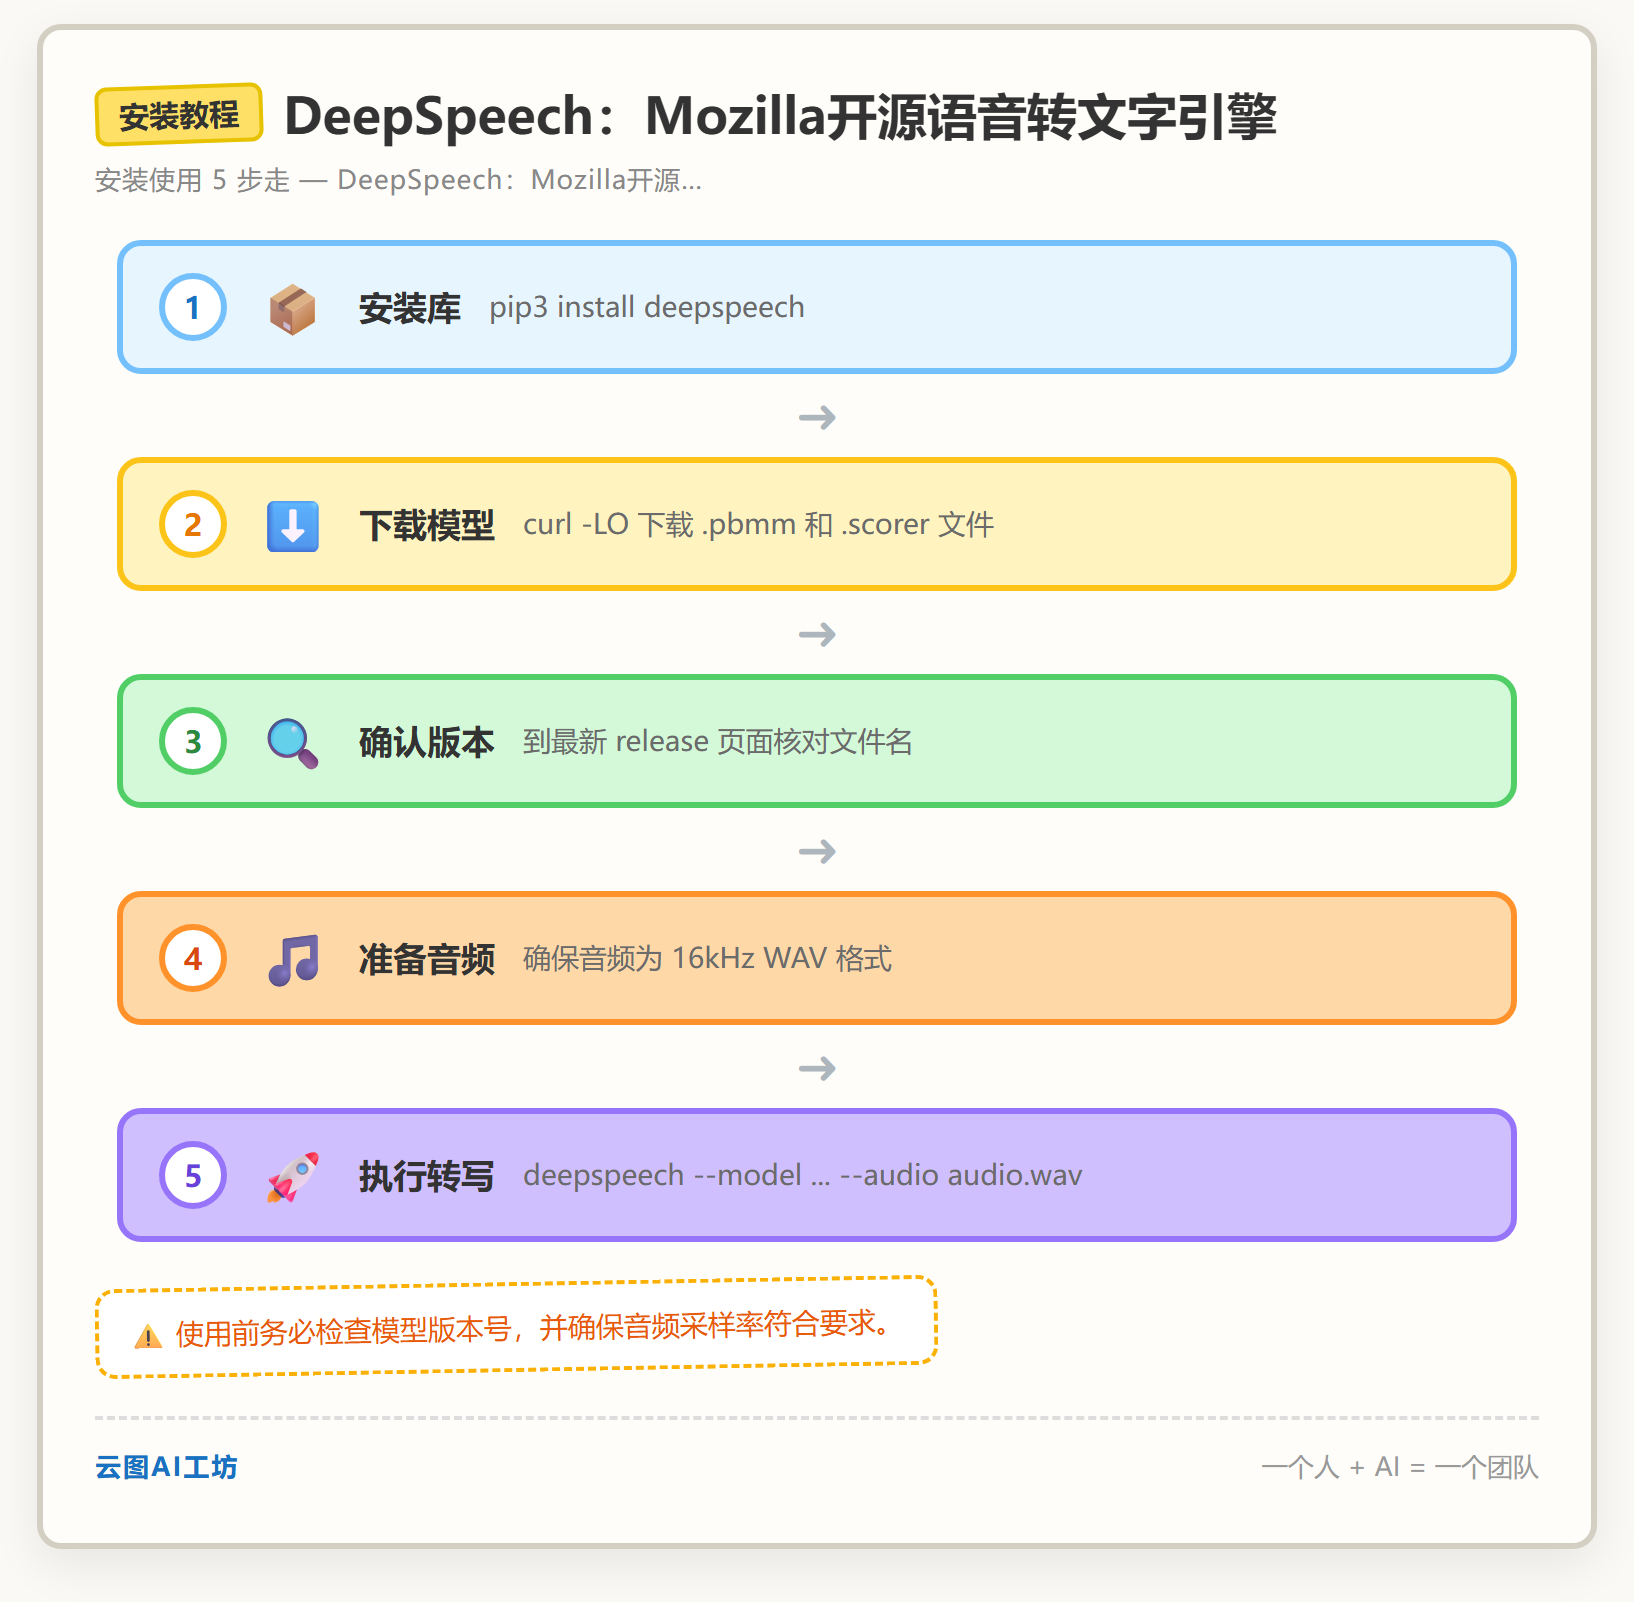
完整文档在 deepspeech.readthedocs.io。官方 README 指定的安装路径和最新版本如下:
# 安装 DeepSpeech 库
pip3 install deepspeech

# 下载官方预训练模型(最新 release 里获取)
# 例如 v0.9.3 的模型文件:
curl -LO https://github.com/mozilla/DeepSpeech/releases/download/v0.9.3/deepspeech-0.9.3-models.pbmm
curl -LO https://github.com/mozilla/DeepSpeech/releases/download/v0.9.3/deepspeech-0.9.3-models.scorer

# 命令行方式转写音频
deepspeech --model deepspeech-0.9.3-models.pbmm --scorer deepspeech-0.9.3-models.scorer --audio audio.wav
注意:实际使用前请到最新 release 页面确认当前的模型文件名和版本号。音频格式一般要求 16kHz 采样率 WAV,mp3 等压缩格式需要先转码。
优点和坑
优点
1. 跨设备能力强。从树莓派 4 到 GPU 服务器都能跑,架构上做了嵌入式适配,不是只能跑在数据中心的玩具。
2. 离线推理、延迟可控。不依赖外网,语音数据本地处理,响应时间可以自己调优。
3. 成熟的开源生态。2016 年创建至今,star 数 26771,文档、社区讨论、衍生项目都很丰富,踩坑经验网上比较容易搜到。
坑
1. 项目已停止维护。README 第一条就写着 discontinued。这意味着没有新功能、新模型发布,bug 修复和社区支持也会慢慢减少。选型时要考虑这个风险。
2. 中文识别效果没有官方保障。官方预训练模型以英文为主,中文需要自己找数据微调,或者用第三方训练好的中文模型——这块质量参差不齐,得自己验证。
3. 部署并非零门槛。虽然可以跑在树莓派上,但环境配置、依赖管理(TensorFlow 版本、Python 版本、系统库)有不少坑,对新手来说可能比想象中费时间。
4. 训练自己的能力要求高。如果想针对特定场景微调,需要准备数据集和 GPU 资源,而且 README 里没有给出具体的训练耗时或数据量参考,得自己摸索。
适合你吗
适合:有比较强的技术背景,正在做离线语音方案的技术选型,愿意花时间处理依赖和适配问题,并且能接受项目已停更、自行维护的风险。如果只是想要一个能跑的语音转文字,可以先用官方预训练模型验证效果,低成本判断方向对不对。
不适合:想要开箱即用、没有专人维护模型的团队——DeepSpeech 需要自己处理模型、部署和可能的适配工作,对没有语音技术积累的团队来说成本不低。另外如果你看重长期维护和持续更新,应该优先考虑活跃度更高的开源语音项目。本拆解基于公开资料整理,没有经过一手实测,具体部署体验和识别效果请在目标设备上自行验证。
常见问题
DeepSpeech 支持中文语音识别吗?
DeepSpeech 官方预训练模型主要以英文为主,中文识别需要自己寻找数据集进行微调,或者使用第三方训练好的中文模型。但需要注意的是,第三方模型质量参差不齐,需要自行验证效果。项目本身已停止维护,中文支持没有官方保障。
DeepSpeech 语音识别效果怎么样?
DeepSpeech 是一个成熟的离线语音识别引擎,在嵌入式设备如树莓派4上可实时运行。其优点是跨设备能力强、离线推理延迟可控。但项目已停止维护,且官方模型对中文识别效果无保障,需自行微调或寻找第三方模型,部署和训练对技术有一定要求。
哪里可以下载 DeepSpeech 的中文模型?
DeepSpeech 官方并未提供预训练的中文模型。你需要自行准备中文数据集对官方模型进行微调,或者在 GitHub 等社区寻找第三方发布的中文模型文件。使用第三方模型时,需注意其质量、适用场景及可能存在的授权问题,务必自行验证。
DeepSpeech 怎么安装和使用?
安装可通过 pip 命令:pip3 install deepspeech。然后从 GitHub Release 页面下载对应的预训练模型文件(.pbmm 和 .scorer)。使用命令行工具时,指定模型和音频文件即可转写,例如:deepspeech --model model.pbmm --scorer model.scorer --audio audio.wav。注意音频需为16kHz WAV格式。
DeepSpeech 是免费的吗?
DeepSpeech 是 Mozilla 开源的免费项目,代码和预训练模型均可免费获取和使用。它主打离线运行,部署后推理只消耗本地计算资源,无需支付云服务费用。但需要注意,项目已标注为“停止维护”,后续需自行承担维护和适配风险。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。