对账发票字段怎么弄:InvoiceNet 批量提取
分类:工具实测 浏览量:9
摘要:
InvoiceNet 是一款开源工具,能从发票的 PDF 或图片中自动提取供应商名称、发票号码、金额、日期等关键字段,帮助电商从业者将对账、录单等繁琐工作自动化。它通过图形界面操作,支持批量处理发票并导出表格,也允许用户自定义字段和用自有发票数据训练专属模型,以提升识别准确率。该工具完全本地运行,适合注重数据隐私、有一定动手能力并愿意准备训练数据的小型电商团队或个体户。
发票信息录入太费手?InvoiceNet 帮你自动抽字段
做电商的都知道,对账、录单、整理供应商发票,看着不多,真干起来能占掉一下午。今天聊的 InvoiceNet 是个开源工具,专门从发票 PDF 或图片里自动提取关键信息——比如供应商名称、发票号码、金额、日期。它带图形界面,不用写代码也能训练自己的模型,把“人工看单敲字”变成“点几下鼠标导出表格”。
适合谁
开网店的小团队:每天要处理进货发票、快递面单、平台账单,手动录入费时还容易错。用 InvoiceNet 批量提取字段,能省下重复敲键盘的时间。
兼职做电商的个体户:没有专门财务,发票整理全靠自己。这工具安装好后,把发票拖进去就能看提取结果,不用懂深度学习。
对数据敏感、想自己掌控流程的店主:不想把发票数据传到第三方云端服务,InvoiceNet 完全本地运行,数据不出自己电脑,隐私上更安心。
能解决什么问题
对账时批量提取发票字段:把一堆 PDF 或 JPG 发票放进一个文件夹,用提取器 GUI 打开,模型自动识别“vendor_name”“invoice_date”“total_amount”这些字段,结果一键保存。不用再一张张翻看、手敲进表格。
自定义要提取的字段:默认有四种字段类型——通用字段(名称、地址)、可选字段(可能不出现的)、金额字段、日期字段。比如你想加一个“tax_id”,打开 invoicenet/__init__.py 加一行 FIELDS["tax_id"] = FIELD_TYPES["optional"] 就行,不用改其他代码。
用你自己的发票训练专属模型:不同行业的发票版式差别很大。InvoiceNet 提供 Trainer GUI,你准备一批自己的发票 PDF 和对应的 JSON 标注文件,就能训练一个更贴合自己业务的模型,识别准确率通常比通用模型更靠谱。
怎么开始用
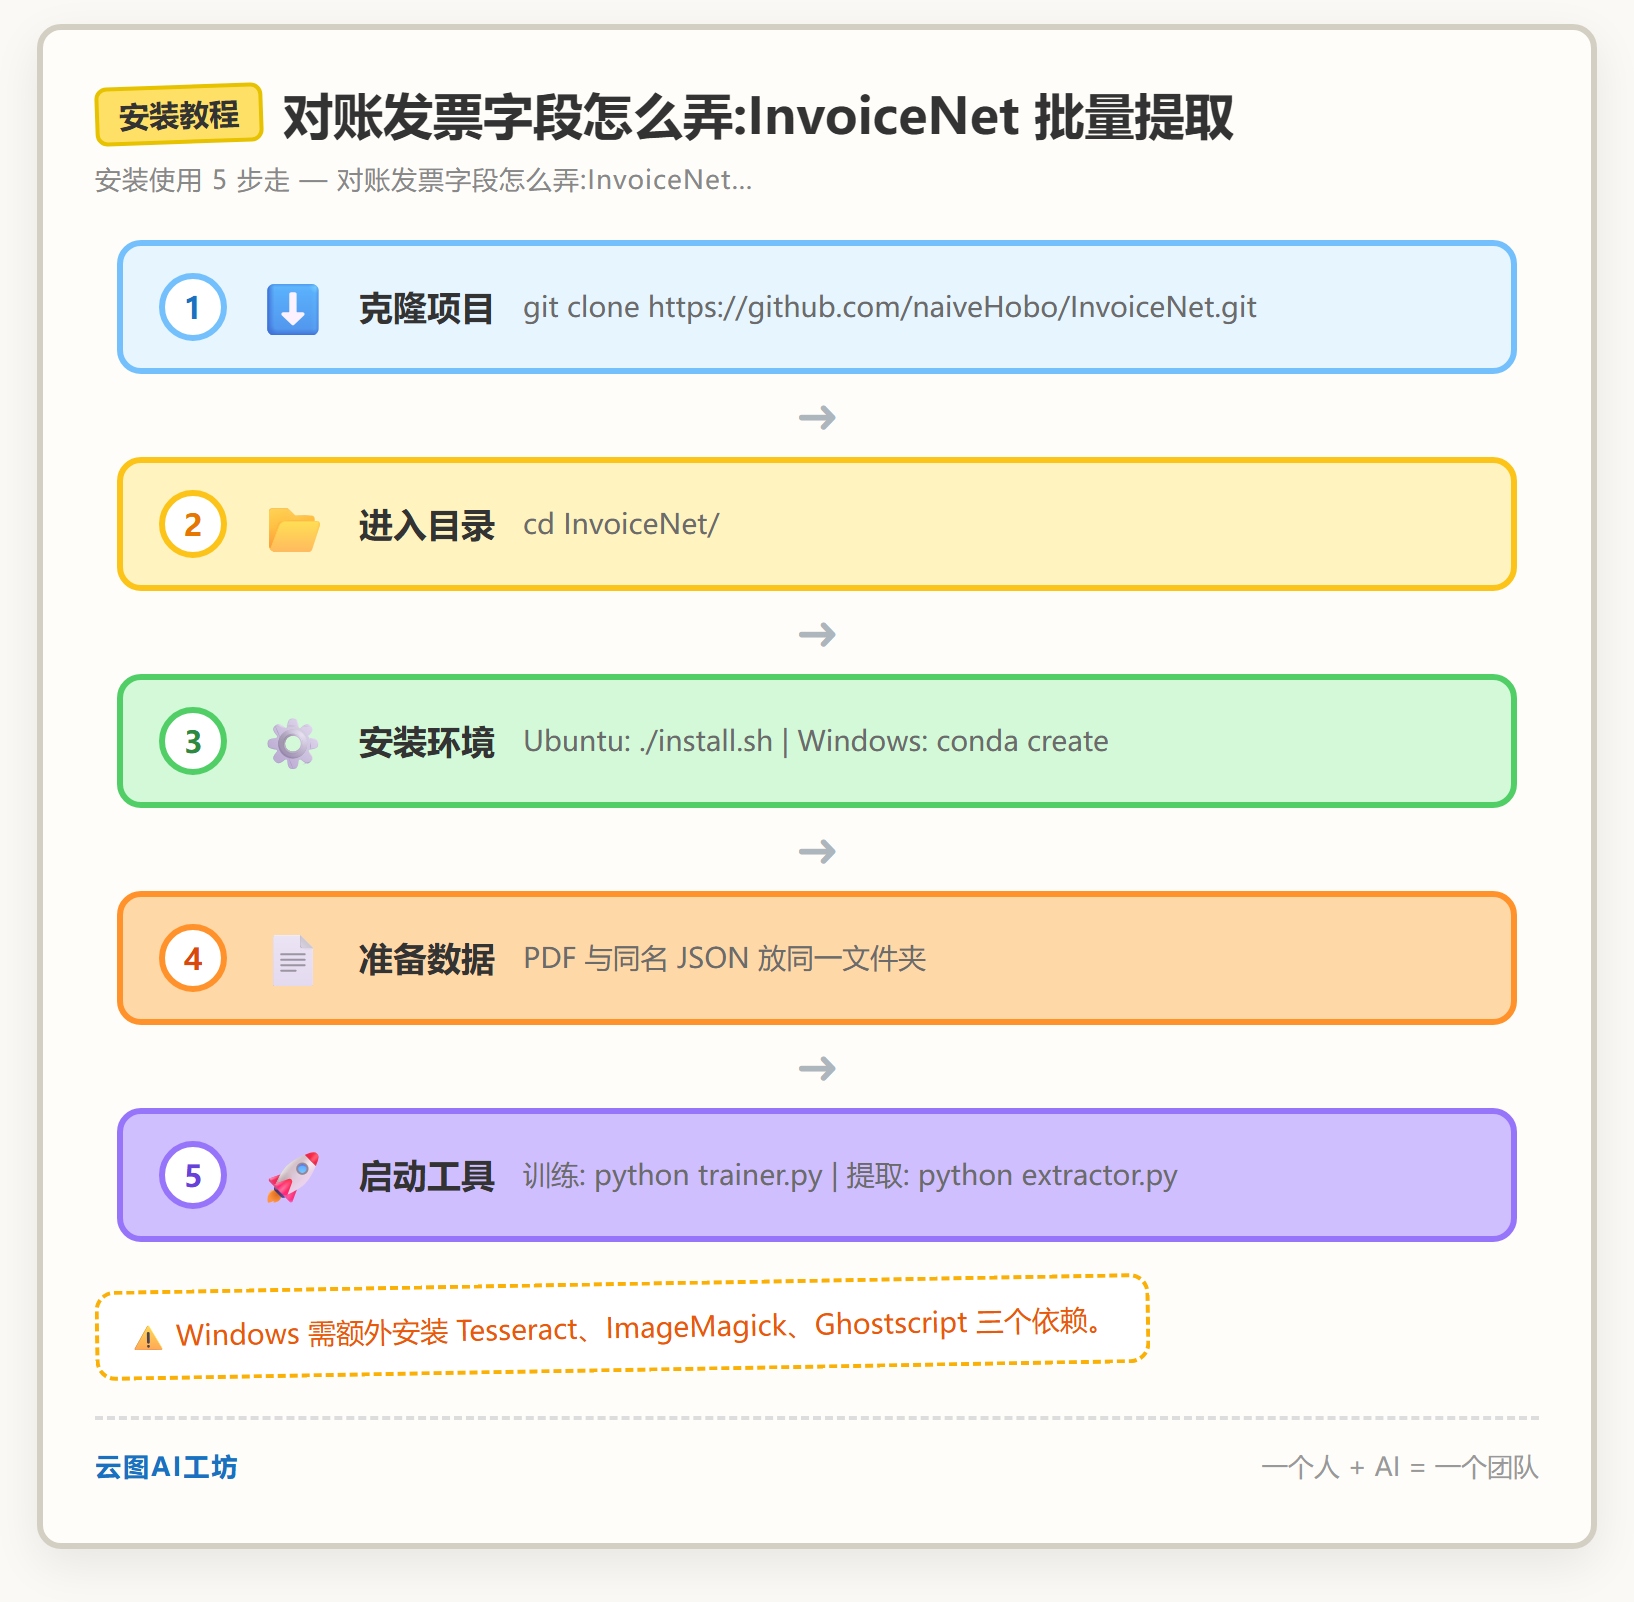
项目在 GitHub 上,star 2696,MIT 协议,可以免费商用。安装分平台:
Ubuntu 20.04 下运行:
git clone https://github.com/naiveHobo/InvoiceNet.git
cd InvoiceNet/

# 运行安装脚本
./install.sh

# 激活虚拟环境
source env/bin/activate
Windows 10 下推荐用 Anaconda:
git clone https://github.com/naiveHobo/InvoiceNet.git
cd InvoiceNet/

# 创建并激活 conda 环境
conda create --name invoicenet python=3.7
conda activate invoicenet

# 安装 InvoiceNet
pip install .

# 安装 poppler
conda install -c conda-forge poppler
Windows 还需要单独装三个依赖:Tesseract 5.0.0、ImageMagick 7.0.10、Ghostscript 9.52。
训练数据要按固定格式放:一个文件夹里,每张发票 PDF 配一个同名 JSON 文件,JSON 里写字段名和值,比如:
{
 "vendor_name":"Nike",
 "invoice_date":"12-01-2017",
 "invoice_number":"R0007546449",
 "total_amount":"137.51"
}
启动图形界面:
# 训练模型
python trainer.py

# 提取发票信息
python extractor.py
优点和坑
优点:
- 全本地运行:发票数据不出电脑,适合对数据隐私有要求的场景。
- 可自定义字段:不用改模型结构,加一行代码就能增加提取字段,灵活度不错。
- 带图形界面:训练和提取都有 GUI,不用记命令行参数,对不熟编程的人友好。
坑:
- 没有现成的通用预训练模型。README 里明确说了,预训练模型“目前不可用”,需要你自己准备数据训练。而发票数据涉及敏感信息,收集大规模公开数据集很难——这意味着你要用,就得先攒一批自己的标注数据。
- 环境配置有门槛。Ubuntu 需要 CUDA 11.8、cuDNN 8.9.7、TensorFlow 2.13.1,版本要求比较死;Windows 要额外装 Tesseract、ImageMagick、Ghostscript 三个外部软件,任何一个装不对都跑不起来。
- 开发时间较早,更新节奏不明。项目创建于 2018 年 7 月,最近一次更新是 2026 年 10 月,但中间间隔较长,依赖的 TensorFlow 版本偏旧,在新硬件或新系统上可能遇到兼容问题。
适合你吗
适合:有一定动手能力、愿意花时间准备标注数据的小团队;对发票数据隐私要求高、不想用云端 OCR 服务的卖家;发票版式相对固定、愿意训练专属模型的用户。
不适合:想“装上就能用”、不想碰训练数据的用户——没有预训练模型这一点会卡住你;完全不懂命令行、也不想学的人,光装环境就可能劝退;发票量特别少、一个月就几张的,手动录入可能更快。
一句话:InvoiceNet 是个思路清晰的开源方案,但它是“半成品”——工具链完整,模型要自己训。适合愿意折腾、且数据能自己搞定的团队。
---
常见问题
InvoiceNet 是免费的吗?
是的,InvoiceNet 是一个开源工具,采用 MIT 协议,可以免费商用。项目在 GitHub 上,任何人都可以免费下载、使用和修改。
InvoiceNet 怎么安装?
安装分平台。Ubuntu 20.04 下运行 ./install.sh 脚本。Windows 10 推荐用 Anaconda:克隆仓库后创建环境,运行 pip install . 安装,并需额外安装 Tesseract、ImageMagick、Ghostscript 三个依赖。
InvoiceNet 能提取哪些发票字段?
默认支持提取通用字段(如供应商名称、地址)、可选字段、金额字段和日期字段。你也可以自定义字段,例如在配置文件里加一行代码就能增加“tax_id”等字段。
InvoiceNet 需要自己训练模型吗?准确率怎么样?
需要。项目没有提供现成的通用预训练模型,你必须用自己的发票 PDF 和对应的 JSON 标注文件来训练专属模型。用自己业务数据训练的模型,识别准确率通常比通用模型更靠谱。
InvoiceNet 和云端 OCR 服务比有什么优势?
主要优势是数据隐私。InvoiceNet 完全本地运行,发票数据不出自己的电脑,适合对数据安全要求高的场景。它还能自定义字段,并用你自己的发票训练更贴合业务的模型。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。