批量生成语音怎么弄:Piper本地TTS部署指南
分类:工具实测 浏览量:5
摘要:
Piper是一个完全本地运行的神经语音合成系统,主打离线、快速、无需联网。它能帮助电商开发者在无网络或对数据隐私有硬性要求的场景下,将文本转为语音,例如为硬件项目添加离线语音播报功能,或为有声书、播客批量生成配音。它特别适合嵌入式开发者、隐私敏感应用(如医疗、金融)以及喜欢自托管、不想为API付费的爱好者。
本地神经语音合成系统Piper:离线TTS怎么部署
Piper是一个本地运行的神经语音合成系统,主打快速、离线、无需联网。对开发者来说,这意味着你可以把文本转语音的能力直接嵌进自己的项目里,不依赖云端API,也不用担心数据外传。它用Python编写,支持多种语言和音色,安装方式也比较直接。
适合谁
嵌入式开发者:想把语音播报功能加进树莓派、智能音箱、门禁系统这类硬件项目里,Piper的本地推理特性很合适,不依赖网络环境。
隐私敏感的应用场景:如果你的产品涉及医疗、金融等数据敏感领域,文本内容不适合发到云端TTS服务,Piper的完全本地运行就能避开这条传输链路。
自托管爱好者:喜欢自己折腾服务、不想为API调用付费的开发者,Piper是MIT协议,完全免费,可以随意改。
能解决什么问题
离线语音播报:在无网络环境下,比如车载系统、工厂设备提示,Piper能直接跑在本地设备上,把状态信息、报警文本转成语音。
批量音频生成:比如给有声书、播客节目批量生成配音,Piper支持命令行调用,可以写脚本一次处理大量文本文件。
多语言支持:Piper提供多种语言的预训练模型,做跨国应用时,可以按需下载对应语言的语音包,不用自己训练模型。
怎么开始用
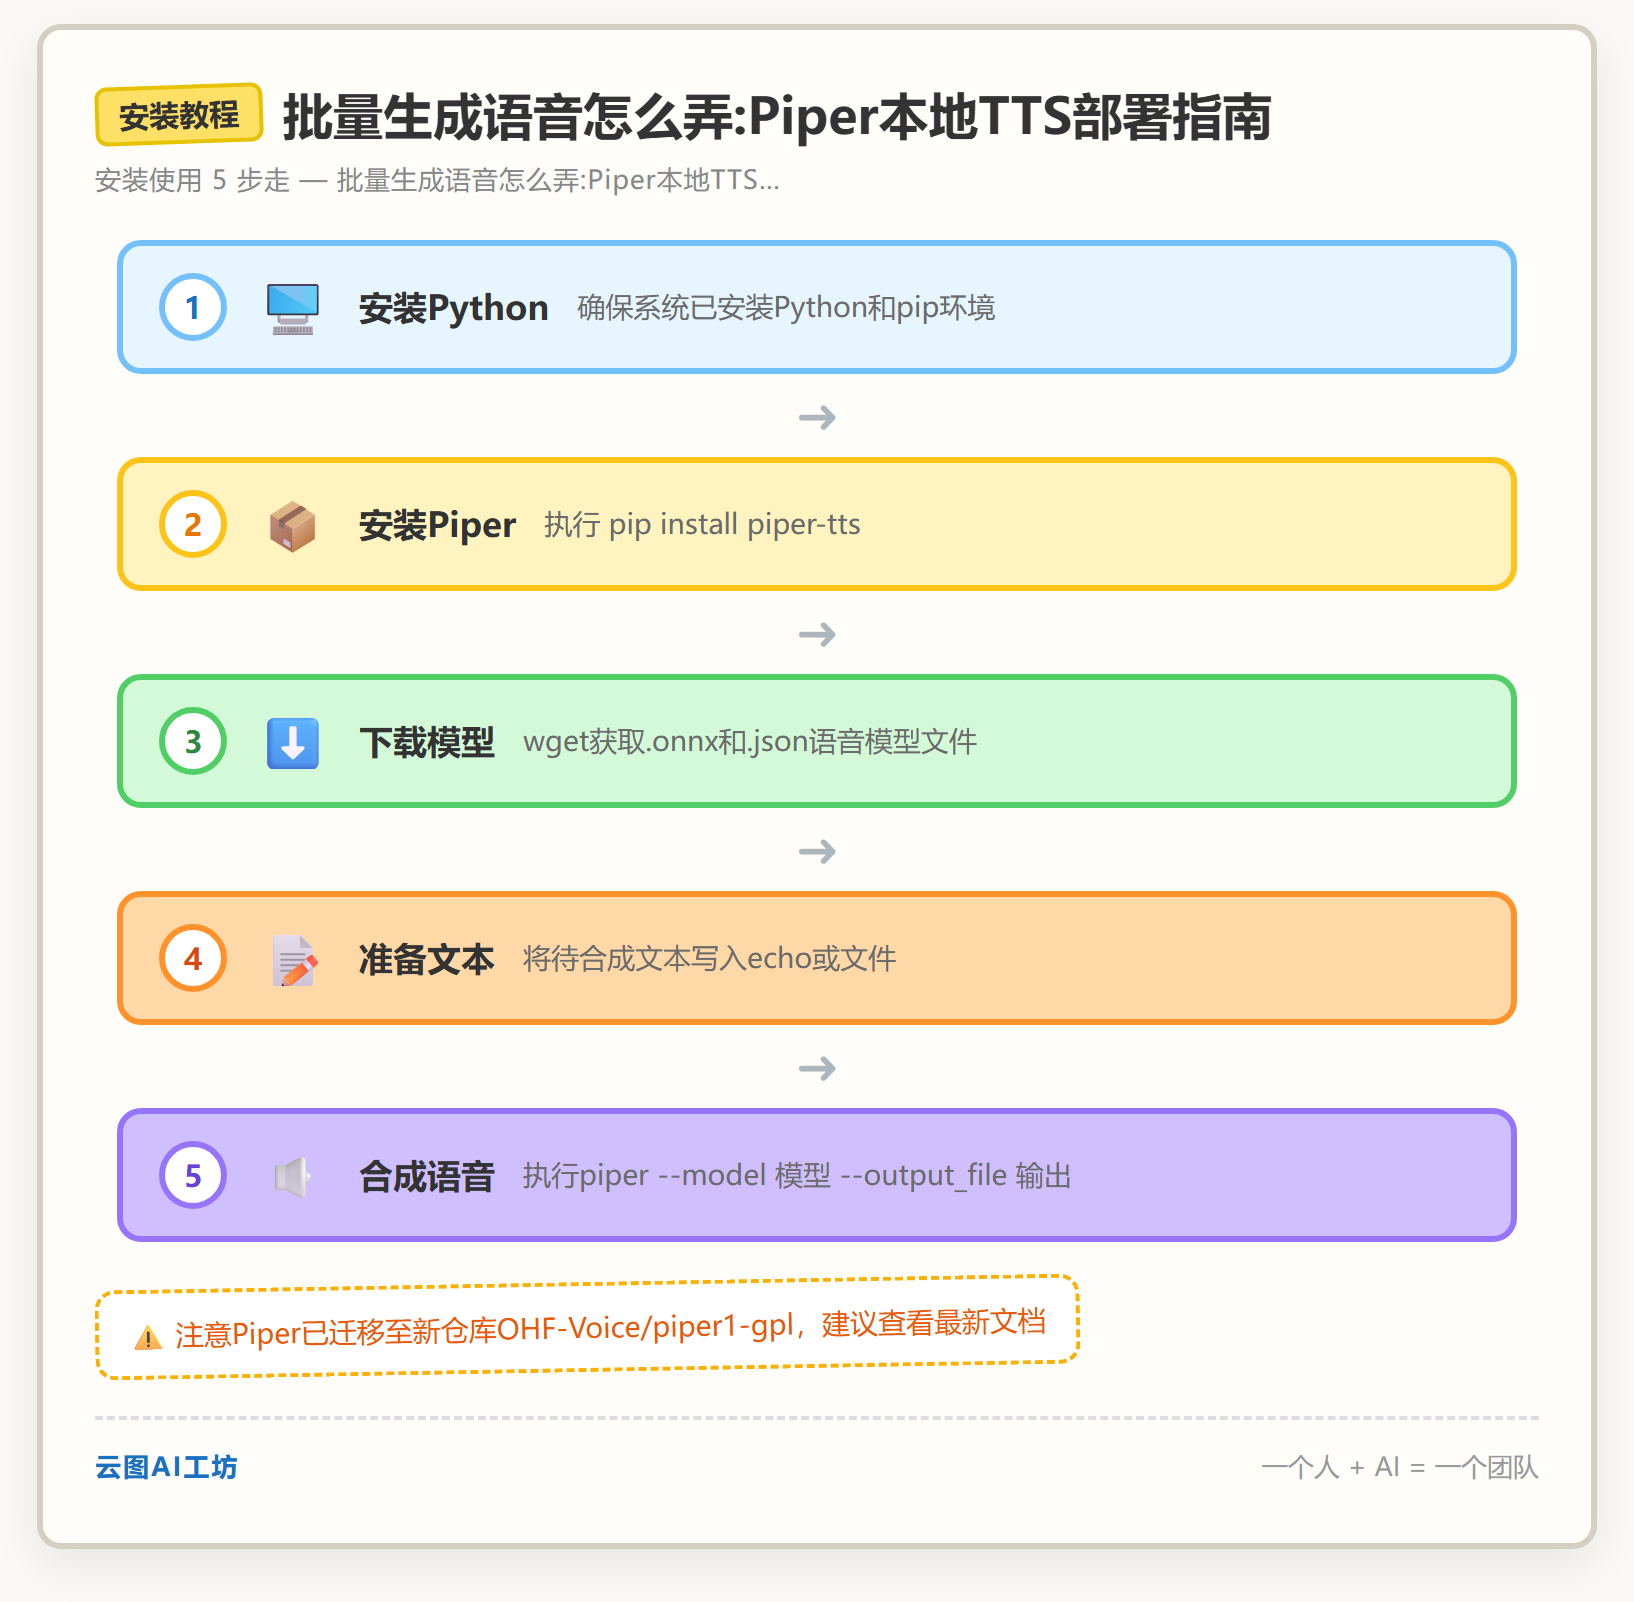
Piper的安装和使用主要依赖Python和pip。官方README给出的基本流程如下:
# 安装piper-tts
pip install piper-tts

# 下载语音模型(以英文女声为例)
wget https://huggingface.co/rhasspy/piper-voices/resolve/v1.0.0/en/en_US/lessac/medium/en_US-lessac-medium.onnx
wget https://huggingface.co/rhasspy/piper-voices/resolve/v1.0.0/en/en_US/lessac/medium/en_US-lessac-medium.onnx.json

# 合成语音
echo 'Welcome to the world of speech synthesis!' | piper
  --model en_US-lessac-medium.onnx
  --output_file welcome.wav
注意,Piper的开发已经迁移到了新仓库(OHF-Voice/piper1-gpl),使用前建议去新地址确认最新的安装方式和模型列表。
优点和坑
优点:
- 完全本地运行:推理过程不联网,数据不出设备,隐私性有保障。
- MIT协议:商用、修改、再分发都没有法律障碍,对商业项目友好。
- 多语言模型:官方提供了多种语言的预训练模型,覆盖常见语种。
坑:
- 开发状态有变动:README明确写了开发已迁移到新仓库,旧仓库可能不再维护,新仓库的协议和API可能有变化,需要留意。
- 音质有上限:Piper的语音质量属于轻量级TTS的正常水平,和云端大模型(如Azure、Google TTS)相比,自然度和表现力有明显差距,不适合对音色要求高的场景。
- 模型文件需要单独下载:语音模型不随pip包一起安装,需要手动从HuggingFace下载,网络不好的环境会比较麻烦。
- 中文支持需自行验证:虽然有多语言模型,但中文音色的质量和数量需要自己去模型列表里确认,官方README没有给出中文效果的详细说明。
适合你吗
适合:如果你在做离线语音播报、嵌入式语音提示、或者对数据隐私有硬性要求的项目,Piper是一个值得试的开源方案。它部署简单、协议宽松,能快速跑通一个本地TTS流程。
不适合:如果你的核心需求是生成高自然度、多情感表现的语音(比如短视频配音、虚拟主播),Piper目前的音质大概率满足不了你。另外,如果你不想折腾模型下载和环境配置,更倾向于开箱即用的云端API,那Piper也不是最优选择。
一句话总结:Piper是一个能用的本地TTS基础方案,适合技术验证和隐私敏感场景,但别指望它达到商业级云TTS的音质。
---
常见问题
Piper TTS 工具是做什么用的?
Piper 是一个完全本地运行的神经语音合成(TTS)系统,主打离线、快速、无需联网。它能将文本转为语音,适合嵌入到树莓派、智能音箱等硬件项目中,或用于批量生成有声书、播客配音,同时保障数据隐私,不依赖云端API。
Piper 怎么安装和部署?
安装 Piper 主要依赖 Python。首先用 pip install piper-tts 安装核心包,然后从 HuggingFace 下载所需的语音模型文件(如英文女声模型),最后通过命令行如 echo ‘文本’ | piper --model 模型文件.onnx --output_file 输出.wav 即可合成语音。
Piper 是免费的吗?
是的,Piper 采用 MIT 协议,完全免费。这意味着你可以商用、修改和再分发,无需为 API 调用付费,对商业项目和自托管爱好者非常友好。
Piper 支持中文语音合成吗?
Piper 官方提供了多种语言的预训练模型,理论上支持中文。但中文音色的具体质量和可用模型需要用户自行到官方模型列表(如 HuggingFace 仓库)中验证和下载,文章中提到官方 README 未对中文效果做详细说明。
Piper 和 edge-tts 这类免费TTS工具比有什么不同?
Piper 的核心优势是完全本地离线运行,数据不出设备,隐私性强,适合嵌入式或敏感数据场景。而 edge-tts 通常需要调用云端服务。但 Piper 的音质属于轻量级水平,自然度可能不如一些云端大模型。
相关工具推荐
- 电商配音批量生成,可以了解另一款免费文字转语音工具 edge-tts
- 像 Zola 批量生成静态网站一样,Piper 也能用于批量生成音频
- 与 HyperFrames 批量生成视频类似,Piper 也支持通过命令行批量处理任务
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。