摘要:
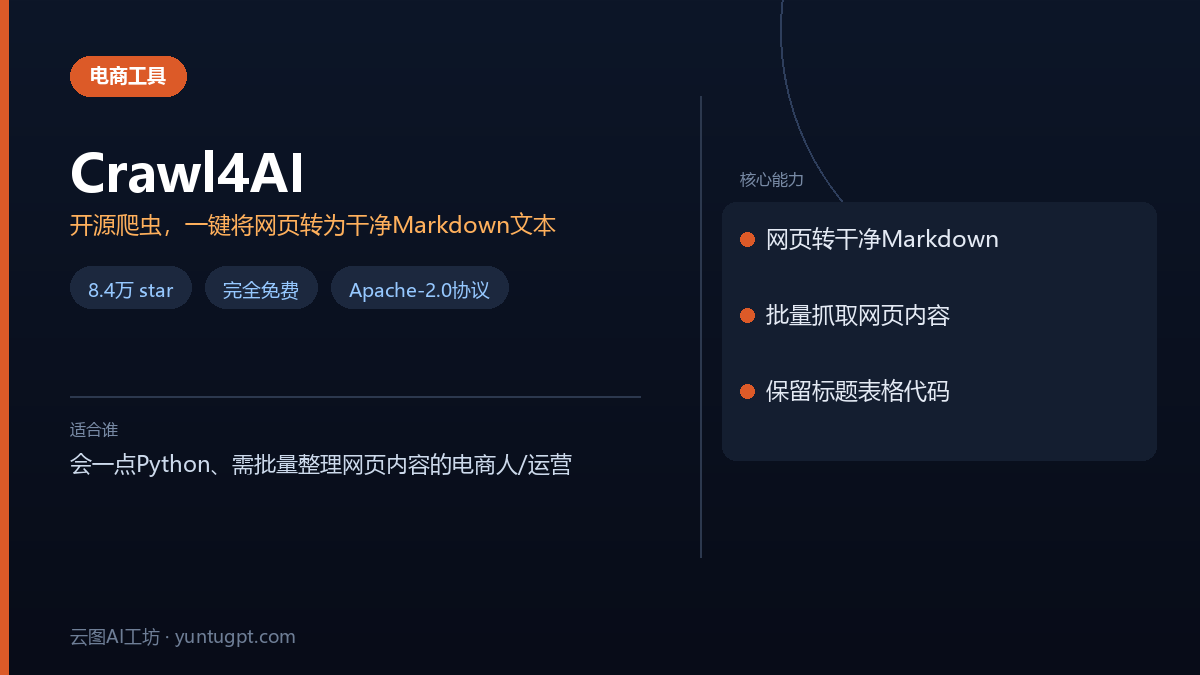
Crawl4AI 是一个开源爬虫工具,能将任意网页内容直接转换为干净、结构化的 Markdown 文本,保留标题、表格和代码。它帮助电商从业者批量整理竞品详情页、收集商品评价与问答、积累行业资讯素材,将网页调研时间从几小时压缩到几分钟。该工具适合开网店的小团队、电商代运营或内容运营人员,以及会一点 Python、愿意花时间配置环境并需要定期批量处理网页内容的用户。
网页内容批量转成干净文本:Crawl4AI 爬虫工具怎么用
做电商的都知道,选品要看竞品详情页、上架要参考同类目描述、客服要查售后政策——这些信息全在网页上。但网页源码里全是广告、导航、弹窗,复制粘贴出来乱成一团,整理一份竞品资料能耗掉半天。Crawl4AI 这个开源爬虫工具,能把任意网页直接转成干净的 Markdown 文本,标题、表格、代码都保留,拿来就能用。对电商人来说,它相当于一个"网页内容整理员",把调研时间从几小时压缩到几分钟。
适合谁
开网店的小团队:需要盯竞品价格、看同行详情页结构、收集用户评价做选品参考,但不想养一个技术岗。
做电商代运营或内容运营的:要给店铺写详情页、做公众号内容,需要大量参考素材,手动复制粘贴效率太低。
会一点 Python 的店主:不排斥敲几行命令,愿意花十分钟装个工具,之后就能反复用。
能解决什么问题
竞品详情页批量整理:把竞品商品页网址整理成一个列表,用 Crawl4AI 批量抓取,输出的是干净的 Markdown,标题层级、表格、图片链接都还在,直接就能对比分析。
商品评价与问答收集:抓取商品评价页,过滤掉页面框架噪音,只留评论文本,方便做差评归类和卖点提炼。
行业资讯与素材积累:把行业新闻、趋势报告页面转成 Markdown 存档,建自己的素材库,写详情页和推文时直接引用。
这个项目在 GitHub 上有 84269 个 star,是目前最热门的开源爬虫项目之一,社区活跃,遇到问题搜得到答案。
怎么开始用
先装 Python 环境,然后打开终端(Mac 用 Terminal,Windows 用 PowerShell),按顺序执行:
pip install -U crawl4ai
crawl4ai-setup
第一条命令安装工具,第二条命令装它需要的浏览器组件,只需要跑一次。装完后,新建一个 Python 文件,写入下面的代码:
import asyncio
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(url="https://news.ycombinator.com")
        print(result.markdown)

asyncio.run(main())
把网址换成你要抓的页面,运行这个文件,终端里就会输出干净的 Markdown 文本。想批量抓多个页面,把代码里的 arun 换成循环就行。
优点和坑
优点:
- 输出干净:直接给 LLM-ready 的 Markdown,标题、表格、代码块都保留,不用二次清洗。
- 免费开源:Apache-2.0 协议,自己跑不花钱,star 数 84269,社区活跃。
- 部署灵活:支持 Python 库、Docker 服务、命令行三种方式,还能用官方云服务免去自己维护浏览器的麻烦。
坑:
- 需要装浏览器:
crawl4ai-setup会下载一个浏览器内核,大概几百 MB,网络不好可能失败,需要重试。 - 有学习门槛:虽然基础用法简单,但想处理登录后才能看的页面、配置代理、处理动态加载内容,需要看官方文档,对纯小白不算友好。
- 动态页面看运气:JavaScript 渲染的页面能不能抓全,取决于页面复杂度和你的配置,官方文档说支持,但实际效果因站而异。
- 资源占用不低:跑批量抓取时,本机内存和 CPU 占用会明显上升,老电脑建议一次别抓太多页面。
适合你吗
适合:会一点 Python、愿意花十几分钟配置环境的电商人;需要定期批量整理网页内容、不想手动复制粘贴的运营;预算有限、不想为爬虫服务付费的小团队。
不适合:完全不想碰命令行、只想点点鼠标的纯小白——那更适合用现成的网页抓取插件或付费服务;只需要偶尔抓一两个页面、频率极低的用户,手动复制可能更快。
如果你符合"会一点技术、有批量抓取需求、想省钱"这三个条件,Crawl4AI 值得花一下午折腾。它解决的是"网页内容变干净文本"这一件事,但这一件事在电商运营里反复出现。
---
常见问题
Crawl4AI 的使用教程是什么?
基础使用教程很简单:1. 安装Python后,在终端运行 pip install -U crawl4ai 和 crawl4ai-setup 命令。2. 新建一个Python文件,复制文章里的示例代码,将url参数换成你要抓取的网页地址。3. 运行这个Python文件,终端就会输出干净的Markdown文本。批量抓取只需将代码放入循环即可。
Crawl4AI 能抓取动态加载的网页内容吗?
可以,但效果因站而异。Crawl4AI 官方文档称支持JavaScript渲染的动态页面,但实际抓取完整性取决于页面复杂度和你的配置。对于纯小白可能有一定门槛,需要仔细阅读官方文档进行配置,不能保证100%抓全所有动态内容。
如何用 Crawl4AI 爬取公众号文章?
方法和其他网页一样。将公众号文章的链接作为url参数,填入文章提供的示例代码中运行即可。Crawl4AI 会过滤掉页面上的广告、导航等噪音,将文章正文、标题、图片链接等转换为干净的Markdown文本,方便你存档或分析。
Crawl4AI 是免费的吗?
是的,完全免费开源。它采用Apache-2.0协议,在GitHub上有超过8.4万个star,你可以自行部署使用,无需付费。此外,它也提供官方云服务选项,可以免去自己维护浏览器环境的麻烦。
安装 Crawl4AI 有什么需要注意的坑?
主要有两点:1. 安装时需要运行crawl4ai-setup下载几百MB的浏览器内核,网络不好可能失败需重试。2. 批量抓取时对本机资源占用不低,内存和CPU使用率会明显上升,老电脑建议一次不要抓取太多页面。
相关工具推荐
官方地址,点开新窗口;本文仅为工具介绍,与该项目无隶属关系。